Środowisko pracy dla przedmiotu informatyka 22.09.2026r.
– obejmuje zarówno fizyczne wyposażenie pracowni, jak i cyfrowe oprogramowanie oraz zasady bezpieczeństwa.
Cyberbezpieczeństwo to ochrona systemów komputerowych, sieci, urządzeń oraz danych przed atakami, uszkodzeniem lub nieautoryzowanym dostępem.
Przykłady cyberprzestępstw:
- Phishing – wyłudzanie danych, np. haseł lub danych karty płatniczej za pomocą fałszywych wiadomości.
- Kradzież tożsamości – wykorzystanie cudzych danych osobowych bez zgody.
- Włamanie do konta – uzyskanie nieuprawnionego dostępu do konta internetowego.
- Oszustwa internetowe – np. fałszywe sklepy, aukcje lub oferty pracy.
- Rozprzestrzenianie złośliwego oprogramowania – np. wirusów, trojanów czy ransomware.
- Cyberstalking – uporczywe nękanie lub prześladowanie kogoś w Internecie.
- Kradzież danych – nielegalne pozyskiwanie i wykorzystywanie poufnych informacji.
- Ataki DDoS – przeciążanie serwera lub strony internetowej w celu uniemożliwienia korzystania z niej.
- Publikowanie cudzych danych lub zdjęć bez zgody – naruszenie prywatności i dóbr osobistych.
- Piractwo komputerowe – nielegalne kopiowanie lub rozpowszechnianie programów, filmów, muzyki czy gier.
Definicja przestępstwa w sieci
Przestępstwo w sieci, czyli cyberprzestępstwo,to czyn niezgodny z prawem, który jest popełniany za pomocą Internetu, komputera, telefonu lub innych urządzeń cyfrowych. Może polegać zarówno na atakowaniu systemów komputerowych i kradzieży danych, jak i na oszukiwaniu, nękaniu czy okradaniu innych osób za pośrednictwem Internetu.
Cyberprzestępstwa mogą powodować straty finansowe, utratę prywatności, kradzież tożsamości, uszkodzenie danych lub utrudnienie korzystania z usług internetowych. Ich ofiarami mogą być osoby prywatne, firmy, szkoły, banki oraz instytucje publiczne.
Do przykładów cyberprzestępstw należą phishing, włamania na konta, kradzież danych osobowych, oszustwa internetowe, rozpowszechnianie złośliwego oprogramowania, cyberstalking oraz ataki DDoS.
Definicja wykroczenia w sieci
Wykroczenie w siecito czyn zabroniony przez prawo, popełniony za pomocą Internetu, komputera, telefonu lub innego urządzenia cyfrowego, który jest mniej poważny niż przestępstwo. Za wykroczenie może grozić między innymi grzywna, nagana lub ograniczenie wolności, zależnie od rodzaju czynu i przepisów.
Wykroczenia w sieci mogą dotyczyć na przykład naruszania prywatności, bezprawnego korzystania z cudzych treści, zakłócania działania usług internetowych czy niewłaściwego zachowania wobec innych użytkowników. Należy pamiętać, że nie każde niewłaściwe zachowanie w Internecie jest wykroczeniem — aby dany czyn był wykroczeniem, musi być określony jako taki w przepisach prawa.
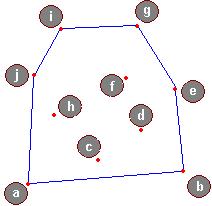
to klasyczny algorytm geometrii obliczeniowej służący do wyznaczania otoczki wypukłej (ang. convex hull) skończonego zbioru punktów na płaszczyźnie. Został opublikowany przez Ronalda Grahama w 1972 roku. [1]
- Wybór punktu startowego (P₀): Znajduje się punkt o najmniejszej współrzędnej y (w przypadku remisu – o najmniejszej współrzędnej x). Jest on na pewno wierzchołkiem otoczki wypukłej. [1]
- Weryfikacja skrętu: Przechodząc przez posortowane punkty, algorytm sprawdza za pomocą iloczynu wektorowego (lub wyznacznika), czy tworzą one skręt w lewo (w kierunku przeciwnym do wskazówek zegara).
- Jeśli następuje skręt w lewo, punkt jest akceptowany i trafia na stos.
Jeśli następuje skręt w prawo (lub współliniowość), wierzchołek ze szczytu stosu jest usuwany, a test jest powtarzany dla wcześniejszych punktów. [1, 2, 3]
Struktury danych – opracowanie
1. Czym są struktury danych?
Struktury danych to sposoby organizowania, przechowywania i porządkowania danych w pamięci komputera. Umożliwiają wykonywanie operacji na danych, takich jak dodawanie, usuwanie, wyszukiwanie i odczytywanie elementów.
Wybór odpowiedniej struktury danych wpływa na wydajność programu, czyli na szybkość wykonywania operacji oraz ilość wykorzystywanej pamięci.
2. Rodzaje struktur danych
Tablica (Array)
Tablica jest strukturą danych przechowującą wiele elementów, do których można uzyskać dostęp za pomocą indeksów. Indeksowanie w większości popularnych języków programowania rozpoczyna się od zera.
Przykład w Pythonie:
python
liczby = [10, 20, 30, 40, 50]
print(liczby[0])  # 10
Główną zaletą tablicy jest szybki dostęp do elementów o znanym indeksie. Wstawianie i usuwanie elementów ze środka może jednak wymagać przesunięcia pozostałych elementów.
Lista wiązana (Linked List)
Lista wiązana składa się z węzłów, z których każdy przechowuje dane oraz odwołanie do kolejnego węzła. W zależności od rodzaju listy węzły mogą również wskazywać poprzednie elementy.
Przykładowa struktura:
10→20→30→40
Zaletą listy wiązanej jest możliwość sprawnego dodawania i usuwania elementów, jeśli znane jest odpowiednie miejsce operacji. Wadą jest brak bezpośredniego dostępu do elementu na podstawie indeksu, co oznacza konieczność przechodzenia przez kolejne węzły.
Stos (Stack)
Stos jest strukturą danych działającą zgodnie z zasadą LIFO (Last In, First Out), czyli ostatni dodany element jest pierwszym usuwanym.
Podstawowe operacje stosu to:
-
-
push– dodawanie elementu na szczyt stosu;
-
-
-
pop– usuwanie elementu ze szczytu stosu;
-
-
-
peek– odczytywanie elementu ze szczytu bez jego usuwania.
-
Stosy są wykorzystywane między innymi do obsługi wywołań funkcji, cofania operacji i przechowywania historii działań.
Kolejka (Queue)
Kolejka jest strukturą danych działającą zgodnie z zasadą FIFO (First In, First Out), czyli pierwszy dodany element jest pierwszym usuwanym.
Podstawowe operacje kolejki to:
-
-
enqueue– dodawanie elementu na końcu kolejki;
-
-
-
dequeue– usuwanie elementu z początku kolejki.
-
Kolejki są stosowane między innymi do obsługi zadań drukowania, przetwarzania zgłoszeń i zarządzania zadaniami oczekującymi na wykonanie.
Tablica mieszająca (Hash Table)
Tablica mieszająca przechowuje dane w postaci par klucz–wartość. Wykorzystuje funkcję haszującą, która przekształca klucz w wartość pozwalającą określić miejsce przechowywania danych.
Przykład w Pythonie:
python
telefony = {
    "Ania": "123456789",
    "Bartek": "987654321"
}

print(telefony["Ania"])
Zaletą tej struktury jest przeciętnie bardzo szybkie wyszukiwanie, dodawanie i usuwanie elementów. Może jednak dochodzić do kolizji, czyli sytuacji, w której różne klucze zostają przypisane do tego samego miejsca. W Pythonie strukturę opartą na tablicy mieszającej wykorzystuje między innymi typ dict.
Drzewo (Tree)
Drzewo jest strukturą danych reprezentującą informacje w sposób hierarchiczny. Składa się z węzłów połączonych relacjami rodzic–dziecko.
Podstawowe pojęcia związane z drzewami to:
-
-
Korzeń (root) – węzeł początkowy drzewa.
-
-
-
Rodzic (parent) – węzeł, z którego prowadzi połączenie do węzła podrzędnego.
-
-
-
Dziecko (child) – węzeł podrzędny.
-
-
-
Liść (leaf) – węzeł, który nie posiada dzieci.
-
Szczególnym rodzajem drzewa jest drzewo binarne, w którym każdy węzeł może mieć maksymalnie dwoje dzieci. Drzewa są wykorzystywane między innymi do organizowania plików i katalogów, wyszukiwania danych oraz reprezentowania hierarchii.
Graf (Graph)
Graf jest strukturą danych składającą się z wierzchołków i krawędzi. Wierzchołki reprezentują obiekty, natomiast krawędzie określają relacje lub połączenia między nimi.
Grafy mogą być skierowane lub nieskierowane. Krawędzie mogą również posiadać wagi określające na przykład odległość, koszt lub czas przejścia.
Grafy są wykorzystywane w systemach nawigacyjnych, sieciach społecznościowych, sieciach komputerowych oraz algorytmach wyszukiwania najkrótszych ścieżek.
3. Wydajność struktur danych i notacja Big O
Wydajność struktur danych określa się między innymi na podstawie czasu wykonywania operacji i ilości potrzebnej pamięci. Do opisywania zależności między liczbą danych a kosztem operacji służy notacja Big O.
-
-
O(1)O(1) – czas stały, niezależny od liczby elementów, np. dostęp do elementu tablicy po indeksie.
-
-
-
O(logn)O(\log n) – czas logarytmiczny, np. wyszukiwanie w zrównoważonym drzewie wyszukiwań.
-
-
-
O(n)O(n) – czas liniowy, np. przeszukiwanie wszystkich elementów nieposortowanej listy.
-
-
-
O(n2)O(n^2) – czas kwadratowy, który występuje między innymi w niektórych algorytmach wykorzystujących dwie zagnieżdżone pętle.
-
Symbol nn oznacza liczbę elementów. Notacja Big O pozwala porównywać wydajność rozwiązań i oceniać, jak będą zachowywać się przy zwiększającej się ilości danych.
4. Różnica między strukturą danych a algorytmem
Struktura danych określa sposób organizacji i przechowywania informacji, natomiast algorytm jest uporządkowanym zestawem instrukcji prowadzących do rozwiązania konkretnego problemu.
Przykładowo tablica może przechowywać liczby, a algorytm sortowania może uporządkować je rosnąco. Struktura danych przechowuje więc informacje, a algorytm wykonuje na nich określone operacje.
5. Podsumowanie
Struktury danych są podstawowym elementem programowania. Umożliwiają efektywne przechowywanie, organizowanie i przetwarzanie informacji. Do najważniejszych struktur należą tablice, listy wiązane, stosy, kolejki, tablice mieszające, drzewa i grafy.
Każda struktura ma swoje właściwości, zalety i ograniczenia. Wybór odpowiedniej zależy od rodzaju danych, wykonywanych operacji oraz wymagań dotyczących wydajności programu. Połączenie właściwej struktury danych z odpowiednim algorytmem pozwala tworzyć efektywne rozwiązania informatyczne.


Przed sortowaniem: 8, 3, 6, 1, 9, 2
Po sortowaniu rosnącym: 1, 2, 3, 6, 8, 9
Istnieje wiele algorytmów sortowania, np. Bubble Sort, Selection Sort, Insertion Sort, Merge Sort oraz Quick Sort.
2. Quick Sort – definicja
Quick Sort – (sortowanie szybkie) to algorytm sortowania danych, który polega na wybieraniu jednego elementu z tablicy, nazywanego pivotem (elementem osiowym), a następnie dzieleniu pozostałych elementów na dwie grupy:
Elementy mniejsze od pivota.
Elementy większe od pivota.
Następnie algorytm ponownie sortuje powstałe części w ten sam sposób, aż wszystkie elementy będą uporządkowane.
Quick Sort wykorzystuje metodę „dziel i zwyciężaj” (ang. divide and conquer).
zpe.gov.pl
+1
3. Jak działa Quick Sort? – przykład
Załóżmy, że mamy następującą tablicę liczb:
[7, 3, 9, 2, 5, 1, 8]
Krok 1. Wybieramy pivot
Wybieramy liczbę 5 jako element osiowy.
Krok 2. Dzielimy liczby na dwie grupy
Mniejsze od 5: [3, 2, 1]
Pivot: [5]
Większe od 5: [7, 9, 8]
Krok 3. Sortujemy obie grupy
Ponownie stosujemy ten sam algorytm do każdej grupy.
Krok 4. Otrzymujemy wynik
WYNIK SORTOWANIA ROSNĄCEGO
1
2
3
5
7
8
9
cs.hmc.edu
+1
4. Zalety i wady Quick Sort
Zalety:
Jest bardzo szybkim algorytmem w większości przypadków.
Dobrze sprawdza się przy dużych zbiorach danych.
Zazwyczaj nie wymaga dużej dodatkowej pamięci.
Jest szeroko stosowany w informatyce.
Wady:
Wybór złego pivota może znacznie spowolnić sortowanie.
W najgorszym przypadku jego działanie może być wolne.
Wykorzystuje rekurencję, czyli wielokrotne wywoływanie samej funkcji.
5. Złożoność obliczeniowa Quick Sort
|
Przypadek |
Złożoność |
|---|---|
|
Najlepszy |
O(n log n) |
|
Średni |
O(n log n) |
|
Najgorszy |
O(n²) |
Oznaczenie n oznacza liczbę elementów do posortowania.
xlinux.nist.gov
+1
6. Linki do stron
Oto przydatne materiały edukacyjne:
Zintegrowana Platforma Edukacyjna – Sortowanieszybkie – wyjaśnienie algorytmu w języku polskim.
ZPE – MetodaQuicksort – opis działania i animacja algorytmu.
NIST –Quicksort – definicja i złożoność algorytmu w języku angielskim.
QuicksortExplained – dokładniejsze wyjaśnienie krok po kroku.
Stanford University – SortingAlgorithms – materiał akademicki dotyczący sortowania.
diagram organizacyjny
Diagram (gr. διάγραμμα – zarys, figura geometryczna) – uproszczona reprezentacja graficzna pewnych pomysłów, idei, konstrukcji, zależności, danych statystycznych, bądź struktur anatomicznych, wykorzystywana we wszystkich dziedzinach życia do obrazowej reprezentacji wiedzy. Człowiek jest istotą, która większość informacji o otoczeniu czerpie ze zmysłu wzroku. Ludzkie oczy są bardzo wrażliwe na kształty i kolory. Jeżeli przekaz, który da się zawrzeć w słowach, zostanie przedstawiony na kolorowym diagramie, to dla odbiorców stanie się on łatwiejszy do zrozumienia. Pewne typy wykresów zwyczajowo nazywane są diagramami.
link do tekstu: https://pl.wikipedia.org/wiki/Diagram