Przykłady przestępstw w sieci (cyberprzestępstw):
Phishing – podszywanie się pod bank, sklep, urząd itp. w celu wyłudzenia loginu, hasła lub danych karty. CERT Polska opisuje m.in. fałszywe strony logowania.
DDoS – celowe przeciążanie serwera lub usługi ogromną liczbą żądań, aby uniemożliwić korzystanie z niej. CERT Polska uwzględnia takie ataki w statystykach incydentów.
Kradzież tożsamości – wykorzystanie cudzych danych lub konta do podszywania się pod inną osobę.
Ransomware – złośliwe oprogramowanie szyfrujące pliki i żądające okupu za ich odzyskanie.
Vishing i oszustwa telefoniczne – oszust podszywa się np. pod pracownika banku i próbuje wyłudzić dane lub nakłonić ofiarę do wykonania przelewu.
Kradzież danych i haseł – np. za pomocą infostealerów, które mogą wykradać dane logowania, cookies czy dane bankowe.
Oszustwa internetowe – np. fałszywe sklepy, aukcje lub oferty inwestycyjne mające skłonić ofiarę do przekazania pieniędzy.
Definicja przestępstwa w sieci
Przestępstwo w sieci (cyberprzestępstwo) to czyn zabroniony przez prawo, który jest popełniany za pomocą internetu, komputera lub innych urządzeń cyfrowych albo jest wymierzony w systemy, dane lub użytkowników. Przykładem jest włamanie na cudze konto, kradzież danych czy oszustwo internetowe.
Definicja wykroczenia w sieci
Wykroczenie w sieci to czyn zabroniony przez prawo, który ma mniejszą szkodliwość niż przestępstwo i może polegać np. na określonym bezprawnym zachowaniu z wykorzystaniem internetu. W polskim prawie o tym, czy dany czyn jest wykroczeniem, decydują konkretne przepisy
Algorytm— jest ciągiem jasno określonych kroków, które przekształcają dane wejściowe w dane wyjściowe, prowadząc od stanu początkowego do pożądanego stanu końcowego Wikipedia+1. Można go porównać do przepisu kulinarnego, w którym każdy krok musi być precyzyjny i wykonalny, aby osiągnąć zamierzony efekt itek.pl. Algorytmy mogą być wykonywane zarówno przez człowieka, jak i komputer, a w informatyce są podstawą programowania i automatyzacji procesów
Pojęcie algorytmu – przecięcie dwóch odcinków Przecięcie dwóch odcinków polega na sprawdzeniu, czy dwa odcinki na płaszczyźnie mają przynajmniej jeden wspólny punkt. Możliwe sytuacje: Odcinki przecinają się – mają jeden wspólny punkt. Odcinki nie przecinają się – nie mają wspólnych punktów. Odcinki nakładają się – mają więcej niż jeden wspólny punkt. Przykład algorytmu Dane: dwa odcinki \(AB\) i \(CD\), określone współrzędnymi swoich końców. Wczytaj współrzędne punktów \(A, B, C, D\).Sprawdź, czy odcinki mają punkt wspólny. Jeżeli mają punkt wspólny, wypisz „Odcinki przecinają się”. W przeciwnym razie wypisz „Odcinki nie przecinają się”.
Zastosowanie: Algorytm ten wykorzystuje się w grafice komputerowej, geometrii i programowaniu.
Przecięcie dwóch odcinków.
Mamy:
AB — pierwszy odcinek
CD — drugi odcinek
Najważniejsza funkcja: long long orient(Point A, Point B, Point C) {
return (B.x-A.x)*(C.y-A.y)
– (B.y-A.y)*(C.x-A.x);
}Mówi ona, po której stronie prostej AB znajduje się C:> 0 — jedna strona< 0 — druga strona= 0 — punkty są współlinioweLiczymy:o1 = orient(A,B,C);
o2 = orient(A,B,D);
o3 = orient(C,D,A);
o4 = orient(C,D,B);Jeżeli C,D są po przeciwnych stronach AB i A,B są po przeciwnych stronach CD, to odcinki się przecinają.Czyli:(o1 > 0 && o2 < 0 || o1 < 0 && o2 > 0)
&&
(o3 > 0 && o4 < 0 || o3 < 0 && o4 > 0)Trzeba jeszcze obsłużyć przypadek orient == 0, czyli gdy punkty są współliniowe i np. jeden odcinek leży na drugim.
Złożoność: O(1)
Materiały: CP- Algorithms — Geometry
USACO Guide — Geometry
1. Orientacja trzech punktów
Używamy wzoru: orient(A,B,C) =
(B.x-A.x)*(C.y-A.y)
– (B.y-A.y)*(C.x-A.x);Wynik:> 0 → C jest po jednej stronie AB< 0 → C jest po drugiej stronie AB= 0 → A, B, C są współliniowe2. Sprawdzamy cztery orientacjeo1 = orient(A,B,C);
o2 = orient(A,B,D);
o3 = orient(C,D,A);
o4 = orient(C,D,B);Jeśli C i D są po przeciwnych stronach AB oraz A i B są po przeciwnych stronach CD, odcinki się przecinają.(o1 > 0 && o2 < 0 || o1 < 0 && o2 > 0)
&&
(o3 > 0 && o4 < 0 || o3 < 0 && o4 > 0)3. Przypadek orient == 0Jeżeli orientacja wynosi 0, punkty są współliniowe.
Trzeba wtedy sprawdzić, czy punkt rzeczywiście znajduje się na odcinku, a nie tylko na tej samej prostej. min(A.x,B.x) <= C.x && C.x <= max(A.x,B.x)
min(A.y,B.y) <= C.y && C.y <= max(A.y,B.y)4. Zapamiętaj orient → sprawdza, po której stronie odcinka/prostej znajduje się punkt.
Do przecięcia dwóch odcinków sprawdzamy 4 orientacje.
Złożoność: O(1) — stała liczba operacji
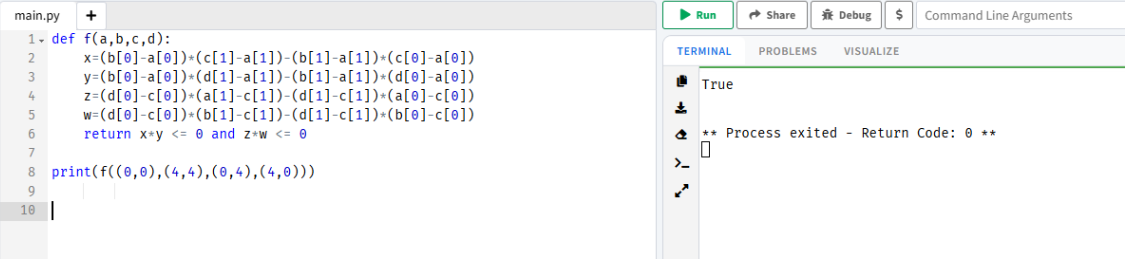
Algorytm sprawdzania przecięcia dwóch odcinków
Algorytm (pseudokod):
Dane: końce dwóch odcinków A, B oraz C, D.
1. Wyznacz położenie punktów względem prostych:
o1 = orientacja(A, B, C)
o2 = orientacja(A, B, D)
o3 = orientacja(C, D, A)
o4 = orientacja(C, D, B)
2. Jeżeli odcinki przecinają się lub mają wspólny punkt, zwróć PRAWDA.
3. W przeciwnym przypadku zwróć FAŁSZ.
Jak działa algorytm?
Algorytm analizuje położenie końców jednego odcinka względem drugiego. Jeżeli punkty znajdują się po przeciwnych stronach odpowiednich prostych, oznacza to, że odcinki się przecinają. Dodatkowo uwzględnia sytuacje, w których końce się stykają lub odcinki leżą na tej samej prostej.
Cel algorytmu: sprawdzenie, czy dwa odcinki posiadają przynajmniej jeden wspólny punkt.
2. Wyjaśnienie prostym językiem
Zadaniem algorytmu jest ustalenie, czy dwa odcinki mają ze sobą jakikolwiek punkt wspólny.
Wyobraź sobie dwa odcinki narysowane na kartce papieru. Algorytm sprawdza, czy się przecinają, dotykają, czy też przebiegają obok siebie.
Krok 1. Na początku algorytm pobiera współrzędne końców obu odcinków. Pierwszy odcinek to AB, a drugi to CD.
Krok 2. Następnie określa położenie punktów względem prostych, na których znajdują się odcinki. Sprawdza, czy punkty leżą po lewej stronie, po prawej stronie, czy bezpośrednio na prostej.
Krok 3. Kolejno sprawdza, czy końce jednego odcinka znajdują się po przeciwnych stronach drugiego odcinka oraz czy zachodzi taka sama sytuacja w drugą stronę. Jeśli tak, oznacza to, że odcinki się przecinają.
Krok 4. Algorytm uwzględnia również przypadki szczególne, np. gdy odcinki stykają się końcami albo znajdują się na jednej prostej i częściowo się pokrywają.
Krok 5. Na końcu zwraca odpowiedni wynik:
PRAWDA – gdy oba odcinki mają przynajmniej jeden wspólny punkt.
FAŁSZ – gdy odcinki nie mają ze sobą żadnego punktu wspólnego.
Najważniejsze do zapamiętania: algorytm wykorzystuje współrzędne punktów oraz obliczenia matematyczne do sprawdzenia, czy dwa odcinki się przecinają. Nie trzeba ich rysować, ponieważ wszystkie potrzebne informacje można uzyskać za pomocą obliczeń.
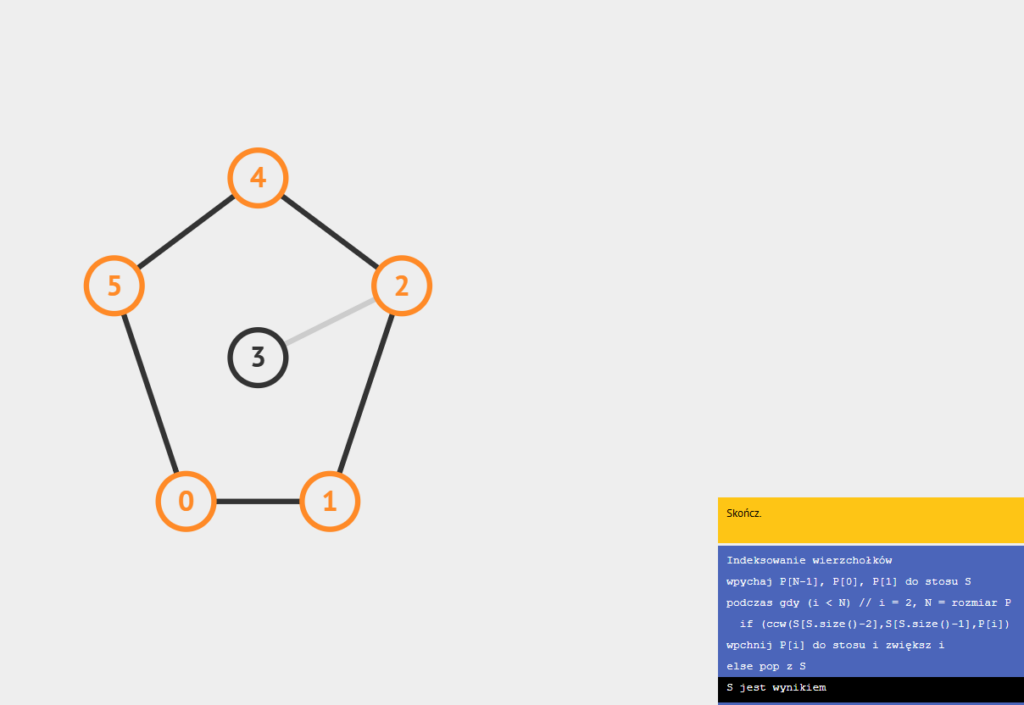
Otoczka wypukła – pojęcie i działanie algorytmu
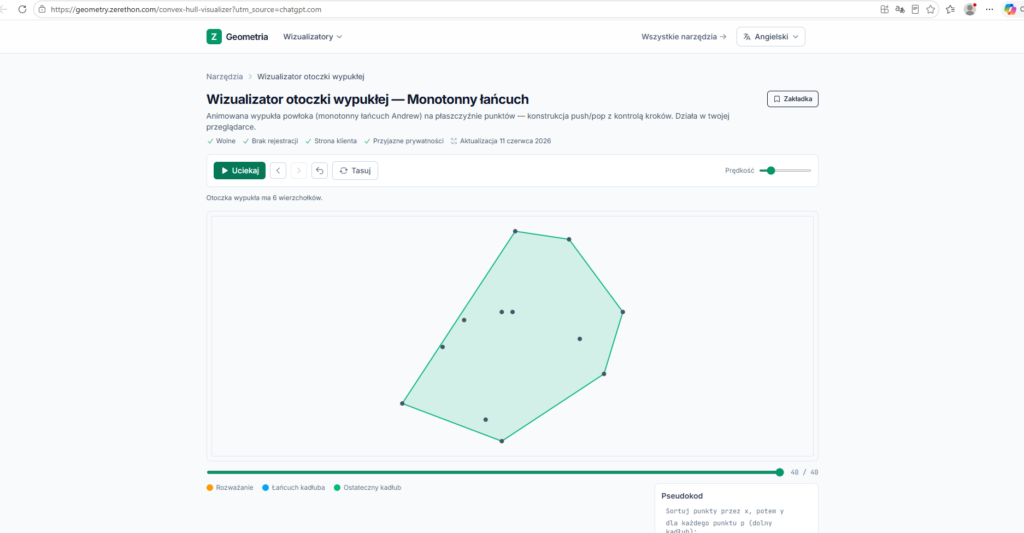
1. Co to jest otoczka wypukła?
Otoczka wypukła (ang. convex hull) to najmniejszy wypukły wielokąt, który obejmuje wszystkie podane punkty na płaszczyźnie.
Można ją sobie wyobrazić jako gumkę recepturkę założoną wokół grupy pinezek wbitych w deskę. Gumka napina się wokół punktów znajdujących się najbardziej na zewnątrz, tworząc zamkniętą granicę.
Punkty znajdujące się wewnątrz wielokąta nie tworzą jego zewnętrznego brzegu. Otoczkę wyznaczają przede wszystkim punkty skrajne.
2. Jak działa algorytm otoczki wypukłej?
Algorytm otrzymuje zbiór punktów o określonych współrzędnych i wyszukuje te, które tworzą zewnętrzną granicę wielokąta.
W uproszczeniu jego działanie wygląda następująco:
Wczytuje punkty – każdy punkt posiada współrzędne xx oraz yy.
Wyszukuje punkty skrajne – określa, które z nich mogą należeć do zewnętrznej granicy.
Wyznacza krawędzie – łączy odpowiednie punkty za pomocą odcinków.
Sprawdza kierunek skrętu – analizuje, czy kolejne punkty tworzą prawidłowy zewnętrzny brzeg.
Usuwa zbędne punkty – pomija punkty, które powodowałyby powstanie wcięcia do wnętrza wielokąta.
Zwraca wynik – uporządkowaną listę punktów tworzących otoczkę wypukłą.
3. Skąd algorytm wie, czy punkt znajduje się we właściwym miejscu?
W jednym z popularnych rozwiązań, czyli algorytmie monotonicznego łańcucha (Andrew’s Monotone Chain), wykorzystywany jest iloczyn wektorowy.
Pozwala on sprawdzić, czy przejście przez trzy punkty AA, BB, CC oznacza skręt w lewo, skręt w prawo czy brak skrętu.
Dla współrzędnych punktów wykonujemy obliczenie:
Interpretacja wyniku:
Jeśli s>0s>0, występuje skręt w lewo.
Jeśli s<0s<0, występuje skręt w prawo.
Jeśli s=0s=0, wszystkie trzy punkty leżą na jednej prostej.
Na podstawie otrzymanego wyniku algorytm decyduje, czy dany punkt powinien pozostać w otoczce, czy należy go usunąć. Decyzja zależy od tego, czy aktualnie budowana jest dolna, czy górna część otoczki.
4. Do czego wykorzystuje się otoczkę wypukłą?
Otoczka wypukła znajduje zastosowanie między innymi w:
grafice komputerowej,
robotyce,
geografii,
analizie danych przestrzennych.
Wykorzystuje się ją wszędzie tam, gdzie potrzebne jest wyznaczenie zewnętrznej granicy zbioru punktów.
Najważniejsze do zapamiętania: otoczka wypukła określa zewnętrzny obrys wszystkich punktów. Algorytm analizuje ich położenie i wybiera te, które tworzą najmniejszy wypukły wielokąt obejmujący cały zbiór.
Otoczka wypukła – algorytm Andrew’a w Pythonie
1. Co to jest otoczka wypukła? (29.09.2026 r.)
Otoczka wypukła (ang. convex hull) to najmniejszy wypukły wielokąt zawierający wszystkie podane punkty.
Można ją porównać do gumki recepturki założonej wokół grupy punktów. Miejsca, w których gumka styka się z najbardziej zewnętrznymi punktami, wyznaczają otoczkę wypukłą.
2. Algorytm Andrew’a
Algorytm Andrew’a, znany również jako Monotone Chain, służy do wyznaczania otoczki wypukłej dla zbioru punktów.
Jego złożoność czasowa wynosi:
Algorytm składa się z kilku głównych etapów:
Sortujemy wszystkie punkty.
Wyznaczamy dolną część otoczki.
Wyznaczamy górną część otoczki.
Łączymy obie części w jeden wielokąt.
3. Iloczyn wektorowy
Jedną z najważniejszych operacji w algorytmie jest sprawdzanie kierunku skrętu trzech punktów.
Dla punktów:
Obliczamy:
W Pythonie możemy zapisać to jako funkcję:
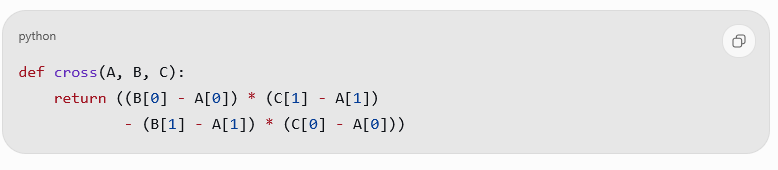
Kod algorytmu w Pythonie
def cross(A, B, C):
    return ((B[0] - A[0]) * (C[1] - A[1])
            - (B[1] - A[1]) * (C[0] - A[0]))


def convex_hull(points):

    # 1. Sortowanie punktów i usuwanie duplikatów
    points = sorted(set(points))

    # 2. Sprawdzenie liczby punktów
    if len(points) <= 1:
        return points

    # 3. Budowanie dolnej części otoczki
    lower = []

    for p in points:
        while len(lower) >= 2 and cross(lower[-2], lower[-1], p) <= 0:
            lower.pop()

        lower.append(p)

    # 4. Budowanie górnej części otoczki
    upper = []

    for p in reversed(points):
        while len(upper) >= 2 and cross(upper[-2], upper[-1], p) <= 0:
            upper.pop()

        upper.append(p)

    # 5. Połączenie obu części
    return lower[:-1] + upper[:-1]
5. Jak działa funkcja cross()?
Załóżmy, że mamy trzy punkty:
Podstawiamy ich współrzędne do funkcji:
cross(A, B, C)Wykonujemy obliczenia:
Otrzymujemy wynik:
Oznacza to, że punkty tworzą skręt w prawo.
6. Dlaczego w algorytmie używamy pętli while?
Jeden z najważniejszych fragmentów kodu wygląda następująco:
while len(lower) >= 2 and cross(lower[-2], lower[-1], p) <= 0:
    lower.pop()
Jego zadaniem jest usuwanie punktów, które nie powinny znajdować się na brzegu otoczki wypukłej.
Działanie tego fragmentu:
Sprawdza, czy lista zawiera przynajmniej dwa punkty.
Analizuje kierunek skrętu trzech ostatnich punktów.
Jeżeli skręt jest nieprawidłowy, usuwa ostatni punkt za pomocą
lower.pop().Ponownie sprawdza kolejne punkty.
Dlaczego używamy while, a nie if?
Ponieważ czasami trzeba usunąć więcej niż jeden punkt, zanim otrzymamy prawidłowy kierunek skrętu.
7. Budowanie dolnej części otoczki
Na początku punkty są sortowane:
points = sorted(set(points))Następnie algorytm przechodzi przez nie od lewej do prawej strony:
for p in points:Każdy kolejny punkt dodawany jest do listy:
lower.append(p)Przed jego dodaniem algorytm sprawdza, czy ostatnie trzy punkty tworzą odpowiedni skręt:
while len(lower) >= 2 and cross(...) <= 0:
    lower.pop()
Jeśli skręt jest nieprawidłowy, ostatni punkt zostaje usunięty.
W ten sposób powstaje dolna część otoczki wypukłej.
8. Budowanie górnej części otoczki
Kolejnym etapem jest wyznaczenie górnej części wielokąta.
Wykonujemy podobne operacje jak przy budowaniu dolnej części, ale tym razem przechodzimy przez punkty w odwrotnej kolejności:
upper = []

for p in reversed(points):
Dzięki temu algorytm porusza się od prawej do lewej strony i wyznacza górną granicę otoczki.
9. Łączenie obu części otoczki
Po wyznaczeniu dolnej i górnej części należy połączyć je w jeden wielokąt.
Służy do tego instrukcja:
return lower[:-1] + upper[:-1]Łączymy dolną część z górną.
Dlaczego używamy [:-1]?
Ponieważ ostatni punkt każdej części jest jednocześnie początkiem drugiej części. Usunięcie tych elementów zapobiega powtarzaniu się punktów w wyniku końcowym.
10. Przykład działania algorytmu
Załóżmy, że mamy następujący zbiór punktów:
points = [
    (0, 0),
    (1, 1),
    (2, 0),
    (1, 0),
    (0, 2),
    (2, 2)
]
Uruchamiamy algorytm:
hull = convex_hull(points)

print(hull)
Otrzymamy następujące punkty tworzące otoczkę:
(0, 0)
(2, 0)
(2, 2)
(0, 2)
Pozostałe punkty:
(1, 0)(1, 1)
nie należą do zewnętrznego brzegu otoczki, dlatego nie zostają uwzględnione jako jej wierzchołki.
11. Złożoność obliczeniowa
Algorytm wykonuje kilka operacji, które wpływają na jego wydajność.
Sortowanie punktów:
sorted(points)Złożoność:
Budowanie dolnej części otoczki:
Budowanie górnej części otoczki:
Łączna złożoność:
Ostatecznie otrzymujemy:
Złożoność czasowa: O(nlogn)O(nlogn).
Złożoność pamięciowa: O(n)O(n).
12. Przypadki szczególne
Algorytm musi również poprawnie obsługiwać nietypowe sytuacje.
Brak punktów:
[]Jeden punkt:
[(2, 3)]Dwa punkty:
[(0, 0), (5, 5)]Punkty leżące na jednej prostej:
(0,0) ---- (1,1) ---- (2,2)W przypadku zastosowania warunku:
cross(...) <= 0punkty znajdujące się pomiędzy skrajnymi zostaną usunięte. W otoczce pozostaną tylko punkty wyznaczające jej końce.
13. Do czego służy set(points)?
W kodzie znajduje się instrukcja:
points = sorted(set(points))Funkcja set() usuwa powtarzające się punkty ze zbioru.
Przykładowo lista:
[
    (0, 0),
    (1, 1),
    (1, 1),
    (2, 0)
]
Po zastosowaniu set() otrzymujemy punkty bez duplikatów:
[
    (0, 0),
    (1, 1),
    (2, 0)
]
Następnie funkcja sorted() ustawia punkty w odpowiedniej kolejności.
Najważniejsze do zapamiętania
Jeżeli masz zapamiętać tylko najważniejsze informacje o algorytmie Andrew’a, zwróć uwagę na następujące rzeczy:
Najpierw sortujemy wszystkie punkty.
Następnie budujemy dolną część otoczki.
Później wyznaczamy górną część otoczki.
Funkcja
cross()sprawdza kierunek skrętu trzech punktów.Przy nieprawidłowym skręcie usuwamy ostatni punkt za pomocą
pop().Na końcu łączymy listy
loweriupper.Złożoność czasowa algorytmu wynosi O(nlogn)O(nlogn).
Najważniejsza funkcja w algorytmie:
def cross(A, B, C):
    return ((B[0] - A[0]) * (C[1] - A[1])
            - (B[1] - A[1]) * (C[0] - A[0]))
Najważniejszy fragment kodu:
while len(lower) >= 2 and cross(lower[-2], lower[-1], p) <= 0:
    lower.pop()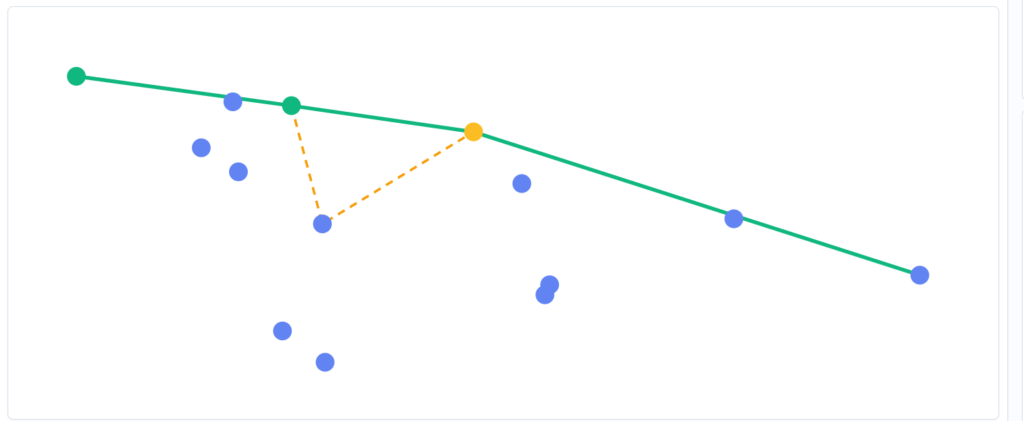
1. Tablice (Arrays) i listy wiązane (Linked Lists)
Cecha | Tablica (Array) | Lista wiązana (Linked List) |
|---|---|---|
Budowa | Elementy przechowywane pod kolejnymi indeksami | Elementy połączone za pomocą wskaźników |
Dostęp do elementu | Bezpośrednio przez indeks | Trzeba przechodzić od początku listy |
Dostęp po indeksie | O(1) | O(n) |
Wyszukiwanie | O(n) | O(n) |
Dodawanie elementów | Może wymagać przesuwania danych | Nie wymaga przesuwania wszystkich elementów |
Usuwanie elementów | Może wymagać przesuwania danych | Zmiana odpowiednich wskaźników |
Pamięć | Zwykle mniejszy narzut | Dodatkowa pamięć na wskaźniki |
Największa zaleta | Szybki dostęp do elementów | Łatwe dodawanie i usuwanie w odpowiednim miejscu |
Do zapamiętania: tablica jest dobra do szybkiego odczytywania danych, a lista wiązana sprawdza się przy częstym dodawaniu i usuwaniu elementów.
2. Rodzaje sortowania (Sorting)
Algorytm | Jak działa? | Najważniejsza cecha |
|---|---|---|
Bubble Sort | Porównuje sąsiednie elementy i zamienia je miejscami | Najprostszy sposób sortowania |
Selection Sort | Wyszukuje najmniejszy element i przenosi go na początek | Wybiera kolejno najmniejsze elementy |
Insertion Sort | Wstawia kolejne elementy na odpowiednie miejsce | Buduje posortowaną część listy |
Przykład sortowania:
Przed sortowaniem | Po sortowaniu |
|---|---|
5, 2, 8, 1 | 1, 2, 5, 8 |
3. Operacje na bitach (Bitmask)
Operacja | Znak | Działanie |
|---|---|---|
AND |
| Wynik 1, gdy oba bity są równe 1 |
OR |
| Wynik 1, gdy przynajmniej jeden bit jest równy 1 |
XOR |
| Wynik 1, gdy bity mają różne wartości |
NOT |
| Odwraca wartości bitów |
Przykład porównania operacji:
Operacja | Przykład | Wynik |
|---|---|---|
AND | 1010 & 1100 | 1000 |
OR | 1010 | 1100 | 1110 |
XOR | 1010 ^ 1100 | 0110 |
Do zapamiętania: maska bitowa pozwala przechowywać i sprawdzać informacje za pomocą wartości 0 i 1.
4. Rodzaje list wiązanych – podstawowe informacje
Pojęcie | Znaczenie |
|---|---|
Node (węzeł) | Pojedynczy element listy |
Data (dane) | Wartość przechowywana w węźle |
Pointer (wskaźnik) | Odwołanie do następnego węzła |
Head (głowa) | Pierwszy element listy |
NULL | Oznacza brak kolejnego elementu |
Przykładowa budowa:
10
Węzeł20
Węzeł30
WęzełNULL
5. Kopiec binarny (Binary Heap)
Cecha | Min-Heap | Max-Heap |
|---|---|---|
Główny element | Najmniejszy | Największy |
Korzeń (root) | Najmniejsza wartość | Największa wartość |
Relacja rodzic–dziecko | Rodzic jest mniejszy lub równy dzieciom | Rodzic jest większy lub równy dzieciom |
Zastosowanie | Szybkie pobieranie minimum | Szybkie pobieranie maksimum |
Porównanie operacji:
Operacja | Złożoność |
|---|---|
Odczytanie minimum w Min-Heap | O(1) |
Odczytanie maksimum w Max-Heap | O(1) |
Dodawanie elementu | O(log n) |
Usuwanie korzenia | O(log n) |
6. Graf (Graph) – najważniejsze pojęcia
Pojęcie | Znaczenie | Przykład |
|---|---|---|
Graph | Zbiór wierzchołków i krawędzi | Mapa dróg |
Vertex / Node | Pojedynczy wierzchołek | Dom |
Edge | Połączenie między wierzchołkami | Droga |
Adjacency List | Lista bezpośrednich połączeń | Home → Store A |
Directed Graph | Graf skierowany | Droga tylko w jedną stronę |
Undirected Graph | Graf nieskierowany | Droga w obie strony |
Przykład listy sąsiedztwa:
Wierzchołek | Sąsiednie wierzchołki |
|---|---|
Home | Store A, Store B, Intersection |
Store A | Home, Store B |
Store B | School |
School | Store B, Intersection |
Intersection | School |
7. Podsumowanie – pierwsze 5 tematów VisuAlgo
Temat | Co oznacza? | Najważniejsza cecha |
|---|---|---|
Array | Tablica | Szybki dostęp przez indeks |
Sorting | Sortowanie | Porządkowanie elementów |
Bitmask | Maska bitowa | Operacje na bitach 0 i 1 |
Linked List | Lista wiązana | Elementy połączone wskaźnikami |
Binary Heap | Kopiec binarny | Szybki dostęp do minimum lub maksimum |
8. Najważniejsze różnice – szybka powtórka przed sprawdzianem
Jeśli w zadaniu pojawia się… | Kojarz z… |
|---|---|
Indeksy zaczynające się od 0 | Array |
Wskaźnik do następnego elementu | Linked List |
Porównywanie sąsiednich elementów | Bubble Sort |
Wybieranie najmniejszego elementu | Selection Sort |
Wstawianie elementu na właściwe miejsce | Insertion Sort |
Operacje AND, OR, XOR | Bitmask |
Rodzic i dwoje dzieci | Binary Heap |
Najmniejszy element na górze | Min-Heap |
Największy element na górze | Max-Heap |
Wierzchołki i krawędzie | Graph |
Lista bezpośrednich połączeń | Adjacency List |
Wniosek: Każda struktura danych i każdy algorytm mają inne zastosowanie. Najważniejsze jest zrozumienie, jak przechowują dane, jakie operacje umożliwiają i kiedy warto ich używać.
1. Bubble Sort (sortowanie bąbelkowe)
Porównuje dwie sąsiednie liczby i zamienia je miejscami, jeśli są w złej kolejności. Powtarza ten proces, aż wszystkie liczby będą uporządkowane. Przykład: [5, 2, 4] → [2, 4, 5]
2. Selection Sort (sortowanie przez wybieranie) Wyszukuje najmniejszy element w nieposortowanej części tablicy i umieszcza go na początku tej części. Następnie przechodzi do kolejnego miejsca.
3. Insertion Sort (sortowanie przez wstawianie) Buduje posortowaną część listy. Każdy kolejny element wstawia w odpowiednie miejsce, przesuwając większe elementy w prawo.
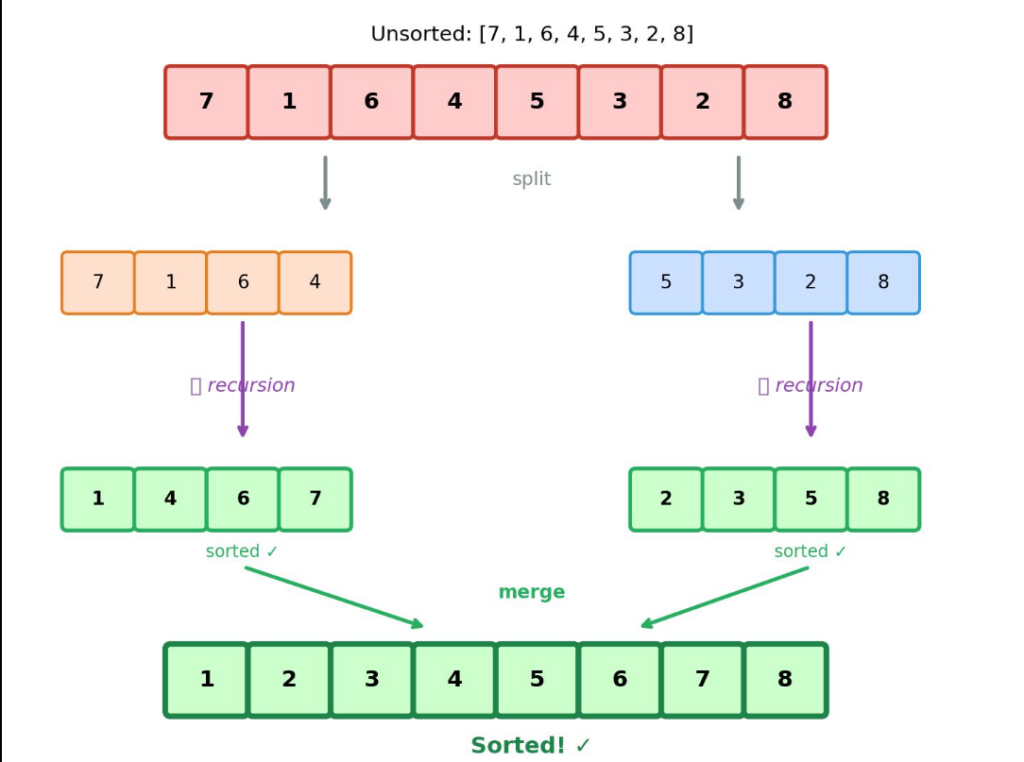
4. Merge Sort (sortowanie przez scalanie) Dzieli listę na mniejsze części, sortuje je, a potem scala w jedną uporządkowaną listę.
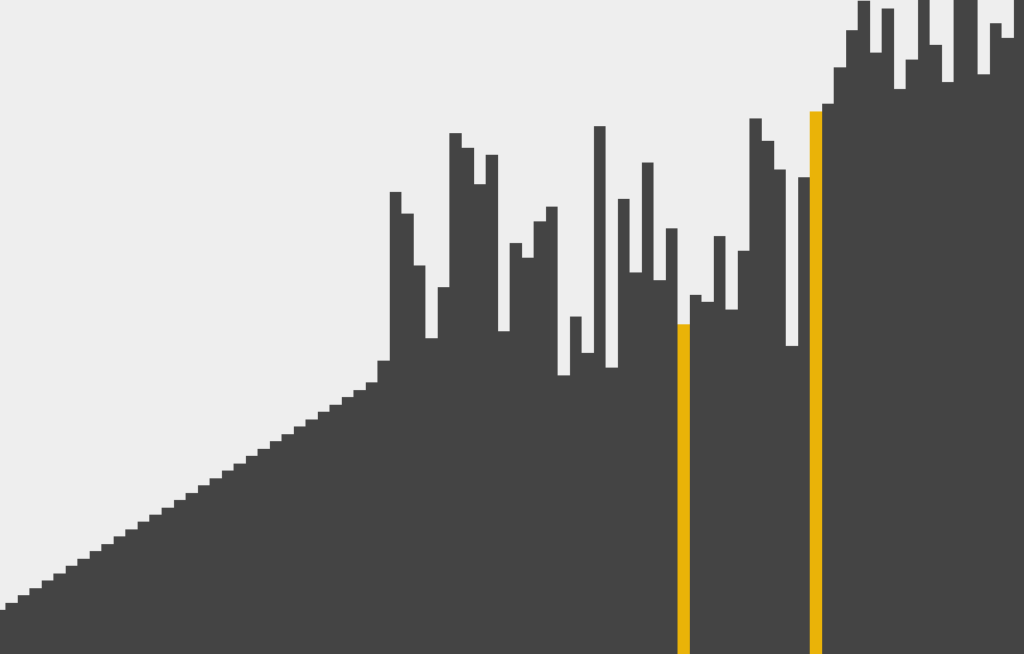
5. Quick Sort (sortowanie szybkie) Wybiera element zwany pivotem. Dzieli pozostałe elementy na mniejsze i większe od pivota, a następnie sortuje te części.
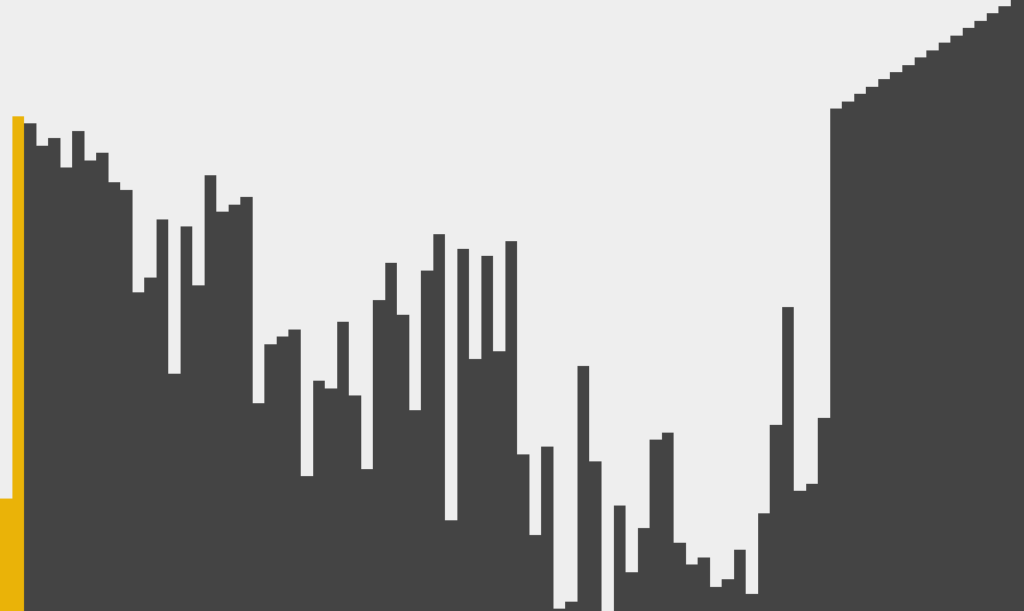
6. Heap Sort (sortowanie przez kopcowanie) Tworzy kopiec, czyli specjalną strukturę drzewa. Następnie wielokrotnie pobiera największy element i umieszcza go na końcu listy.
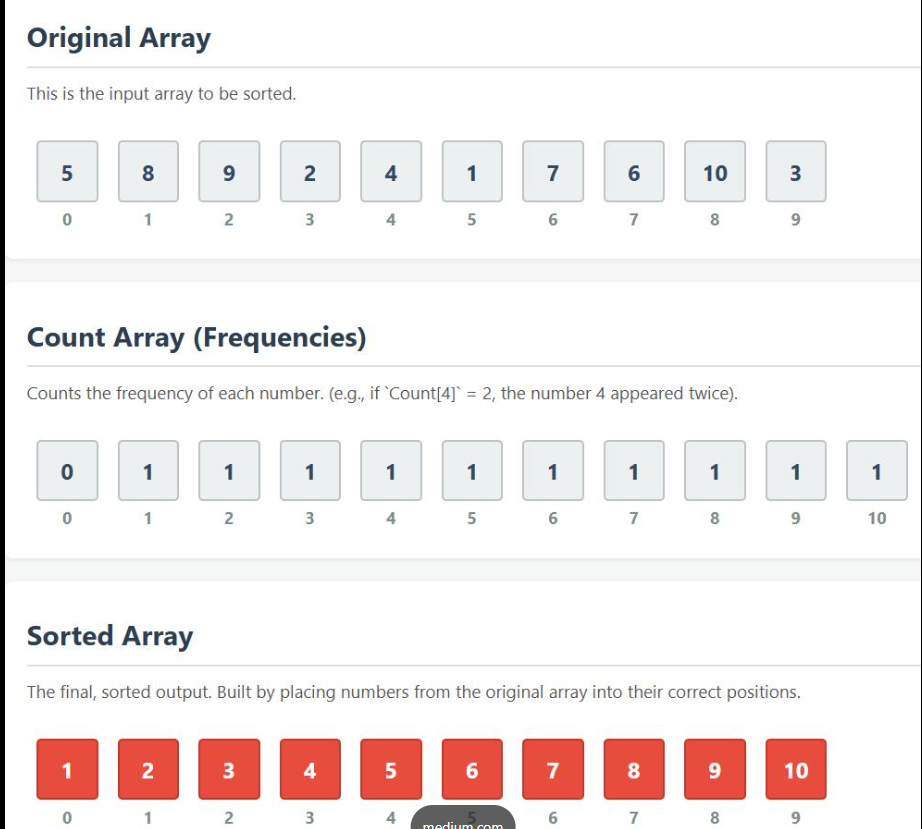
7. Counting Sort (sortowanie przez zliczanie) Zlicza, ile razy występuje każda wartość, a następnie odtwarza listę w odpowiedniej kolejności. Najlepiej działa dla liczb całkowitych z ograniczonego zakresu.
8. Radix Sort (sortowanie pozycyjne) Sortuje liczby według kolejnych cyfr, np. najpierw jedności, potem dziesiątek, a następnie setek.
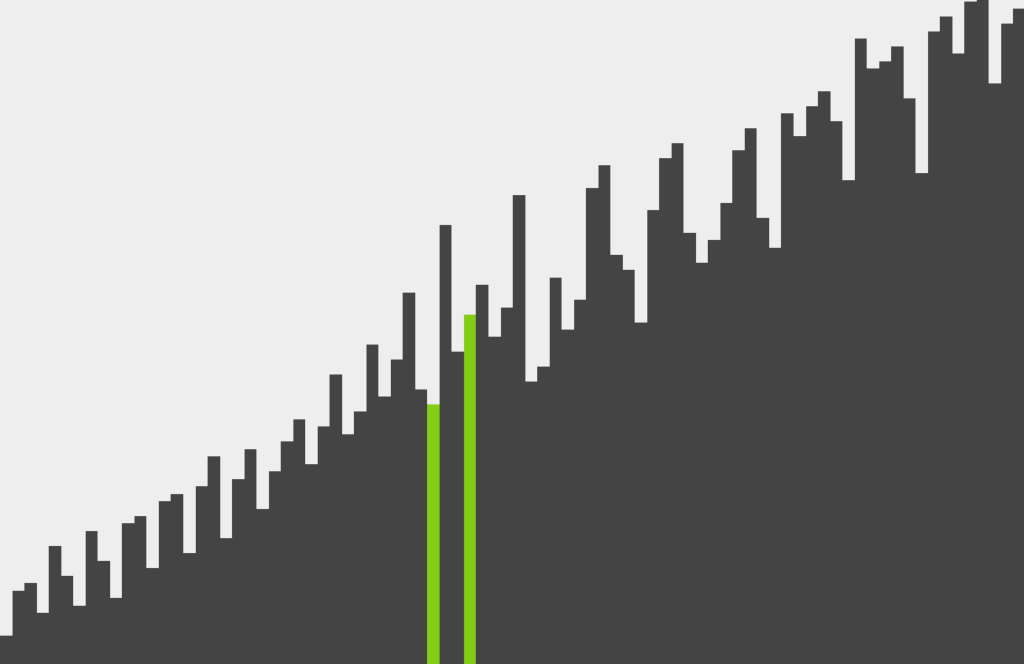
9. Shell Sort (sortowanie Shella) Porównuje elementy oddalone od siebie o określony odstęp. Stopniowo zmniejsza odstęp, aż wynosi on 1, wykonując końcowe sortowanie przez wstawianie.
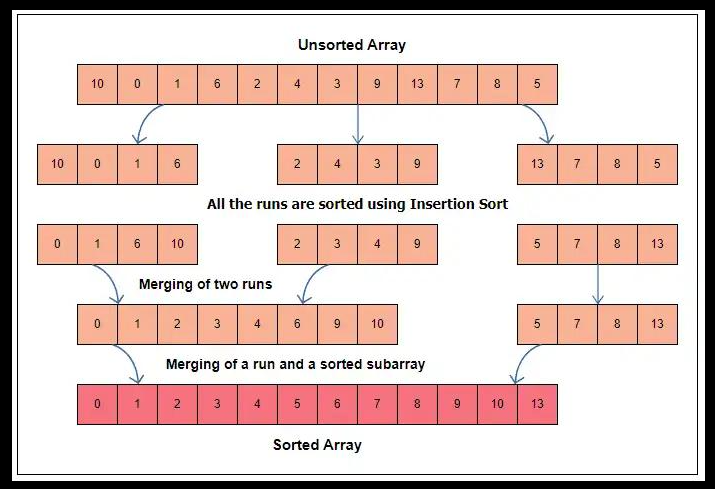
10. Timsort Łączy sortowanie przez wstawianie i scalanie. Wykorzystuje już uporządkowane fragmenty danych, dlatego dobrze sprawdza się w praktyce. Jest stosowany m.in. w Pythonie przy sortowaniu list.