Przykłady przestępstw w sieci (cyberprzestępstw): 22.09.2026r.


Phishing – podszywanie się pod bank, sklep, urząd itp. w celu wyłudzenia loginu, hasła lub danych karty. CERT Polska opisuje m.in. fałszywe strony logowania.
Kradzież tożsamości – wykorzystanie cudzych danych lub konta do podszywania się pod inną osobę.
Ransomware – złośliwe oprogramowanie szyfrujące pliki i żądające okupu za ich odzyskanie.
Kradzież danych i haseł – np. za pomocą infostealerów, które mogą wykradać dane logowania, cookies czy dane bankowe.
Oszustwa internetowe – np. fałszywe sklepy, aukcje lub oferty inwestycyjne mające skłonić ofiarę do przekazania pieniędzy.
DDoS – celowe przeciążanie serwera lub usługi ogromną liczbą żądań, aby uniemożliwić korzystanie z niej. CERT Polska uwzględnia takie ataki w statystykach incydentów.
Vishing i oszustwa telefoniczne – oszust podszywa się np. pod pracownika banku i próbuje wyłudzić dane lub nakłonić ofiarę do wykonania przelewu.


Źródła, z których korzystałem
CERT Polska – raport roczny 2025
CERT Polska – przegląd kampanii phishingowych
CERT Polska – ransomware w raporcie za 2024 r.
CERT Polska – ataki socjotechniczne
CERT Polska – infostealery i kradzież danych 


Definicja przestępstwa w sieci
Przestępstwo w sieci (cyberprzestępstwo) to czyn zabroniony przez prawo, który jest popełniany za pomocą internetu, komputera lub innych urządzeń cyfrowych albo jest wymierzony w systemy, dane lub użytkowników. Przykładem jest włamanie na cudze konto, kradzież danych czy oszustwo internetowe.

Definicja wykroczenia w sieci
Wykroczenie w sieci to czyn zabroniony przez prawo, który ma mniejszą szkodliwość niż przestępstwo i może polegać np. na określonym bezprawnym zachowaniu z wykorzystaniem internetu. W polskim prawie o tym, czy dany czyn jest wykroczeniem, decydują konkretne przepisy

Algorytm-- jest ciągiem jasno określonych kroków, które przekształcają dane wejściowe w dane wyjściowe, prowadząc od stanu początkowego do pożądanego stanu końcowego Wikipedia+1. Można go porównać do przepisu kulinarnego, w którym każdy krok musi być precyzyjny i wykonalny, aby osiągnąć zamierzony efekt itek.pl. Algorytmy mogą być wykonywane zarówno przez człowieka, jak i komputer, a w informatyce są podstawą programowania i automatyzacji procesów           ( 15.09.2026r.)

Pojęcie algorytmu – przecięcie dwóch odcinków Przecięcie dwóch odcinków polega na sprawdzeniu, czy dwa odcinki na płaszczyźnie mają przynajmniej jeden wspólny punkt. Możliwe sytuacje: Odcinki przecinają się – mają jeden wspólny punkt. Odcinki nie przecinają się – nie mają wspólnych punktów. Odcinki nakładają się – mają więcej niż jeden wspólny punkt. Przykład algorytmu Dane: dwa odcinki \(AB\) i \(CD\), określone współrzędnymi swoich końców. Wczytaj współrzędne punktów \(A, B, C, D\).Sprawdź, czy odcinki mają punkt wspólny. Jeżeli mają punkt wspólny, wypisz „Odcinki przecinają się”. W przeciwnym razie wypisz „Odcinki nie przecinają się”.
Zastosowanie: Algorytm ten wykorzystuje się w grafice komputerowej, geometrii i programowaniu.


Przecięcie dwóch odcinków
Mamy:
AB — pierwszy odcinek
CD — drugi odcinek
Najważniejsza funkcja: long long orient(Point A, Point B, Point C) {
return (B.x-A.x)*(C.y-A.y)
- (B.y-A.y)*(C.x-A.x);
}Mówi ona, po której stronie prostej AB znajduje się C:> 0 — jedna strona< 0 — druga strona= 0 — punkty są współlinioweLiczymy:o1 = orient(A,B,C);
o2 = orient(A,B,D);
o3 = orient(C,D,A);
o4 = orient(C,D,B);Jeżeli C,D są po przeciwnych stronach AB i A,B są po przeciwnych stronach CD, to odcinki się przecinają.Czyli:(o1 > 0 && o2 < 0 || o1 < 0 && o2 > 0)
&&
(o3 > 0 && o4 < 0 || o3 < 0 && o4 > 0)Trzeba jeszcze obsłużyć przypadek orient == 0, czyli gdy punkty są współliniowe i np. jeden odcinek leży na drugim.
Złożoność: O(1)
Materiały: CP- Algorithms — Geometry
USACO Guide — Geometry


1. Orientacja trzech punktów
Używamy wzoru: orient(A,B,C) =
(B.x-A.x)*(C.y-A.y)
- (B.y-A.y)*(C.x-A.x);Wynik:> 0 → C jest po jednej stronie AB< 0 → C jest po drugiej stronie AB= 0 → A, B, C są współliniowe2. Sprawdzamy cztery orientacjeo1 = orient(A,B,C);
o2 = orient(A,B,D);

o3 = orient(C,D,A);
o4 = orient(C,D,B);Jeśli C i D są po przeciwnych stronach AB oraz A i B są po przeciwnych stronach CD, odcinki się przecinają.(o1 > 0 && o2 < 0 || o1 < 0 && o2 > 0)
&&
(o3 > 0 && o4 < 0 || o3 < 0 && o4 > 0)3. Przypadek orient == 0Jeżeli orientacja wynosi 0, punkty są współliniowe.
Trzeba wtedy sprawdzić, czy punkt rzeczywiście znajduje się na odcinku, a nie tylko na tej samej prostej. min(A.x,B.x) <= C.x && C.x <= max(A.x,B.x)
min(A.y,B.y) <= C.y && C.y <= max(A.y,B.y)4. Zapamiętaj orient → sprawdza, po której stronie odcinka/prostej znajduje się punkt.
Do przecięcia dwóch odcinków sprawdzamy 4 orientacje.
Złożoność: O(1) — stała liczba operacji.
Linki
CP-Algorithms: Geometry — https://cp-algorithms.com/geometry/basic-geometry.htmlUSACO
Guide: Geometry — https://usaco.guide/plat/geo


Jak działa algorytm przecięcia dwóch odcinków?
Algorytm sprawdza, czy dwa odcinki na płaszczyźnie mają wspólny punkt. Wykorzystuje do tego współrzędne końców odcinków.1. Kolejne kroki algorytmu.
Wczytujemy dane – współrzędne końców obu odcinków: \(A, B, C, D\).Sprawdzamy położenie odcinków – ustalamy, czy odcinki przecinają się, czy leżą po przeciwnych stronach swoich prostych.
Sprawdzamy szczególne przypadki – jeśli końce odcinków leżą na jednej prostej, sprawdzamy, czy odcinki stykają się lub nakładają. Podajemy wynik – wypisujemy, czy odcinki mają wspólny punkt.

3. Jak komputer to sprawdza?
Komputer wykorzystuje obliczenia matematyczne na współrzędnych punktów. Sprawdza, po której stronie prostej znajduje się koniec drugiego odcinka. Jeżeli końce odcinków leżą po przeciwnych stronach odpowiednich prostych, odcinki przecinają się. Trzeba też osobno sprawdzić sytuację, w której odcinki leżą na jednej prostej i mogą się stykać.
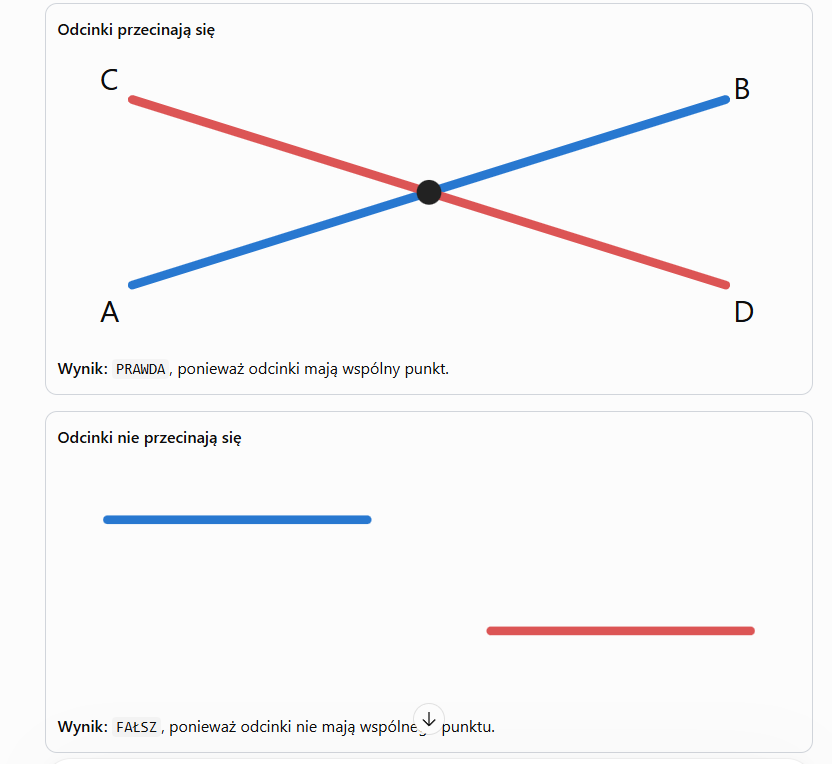


Algorytm przecięcia dwóch odcinków

Algorytm (pseudokod):

Dane: końce odcinków A, B oraz C, D

1. Oblicz położenie punktów względem prostych:
o1 = orientacja(A, B, C)
o2 = orientacja(A, B, D)
o3 = orientacja(C, D, A)
o4 = orientacja(C, D, B)

2. Jeśli odcinki przecinają się lub stykają:
zwróć PRAWDA

3. W przeciwnym razie:
zwróć FAŁSZ


Jak działa?

Algorytm sprawdza położenie końców jednego odcinka względem drugiego. Jeśli końce leżą po przeciwnych stronach odpowiednich prostych, odcinki się przecinają. Sprawdza też, czy końce odcinków stykają się lub leżą na wspólnej prostej.

Cel algorytmu: ustalić, czy dwa odcinki mają przynajmniej jeden wspólny punkt.


2. Wyjaśnienie prostym językiem

Celem algorytmu jest sprawdzenie, czy dwa odcinki mają wspólny punkt.

Wyobraź sobie dwa odcinki narysowane na kartce. Algorytm musi ustalić, czy się przecinają, czy mijają się bez dotykania.

Krok 1. Algorytm pobiera współrzędne końców obu odcinków. Odcinek AB ma końce A i B, a odcinek CD ma końce C i D.

Krok 2. Sprawdza położenie punktów względem prostych, na których leżą odcinki. Ustala, czy punkty znajdują się po lewej stronie, po prawej stronie, czy dokładnie na prostej.

Krok 3. Sprawdza, czy końce jednego odcinka leżą po przeciwnych stronach drugiego odcinka i odwrotnie. Jeżeli tak, odcinki przecinają się.

Krok 4. Sprawdza sytuacje szczególne, na przykład gdy odcinki stykają się końcami albo leżą na tej samej prostej i częściowo na siebie zachodzą.

Krok 5. Zwraca wynik:

  • PRAWDA – odcinki mają co najmniej jeden wspólny punkt.

  • FAŁSZ – odcinki nie mają żadnego wspólnego punktu.

Najważniejsze do zapamiętania: algorytm wykorzystuje współrzędne punktów i ich wzajemne położenie, aby ustalić, czy odcinki się przecinają. Nie musi ich rysować — wystarczą odpowiednie obliczenia matematyczne.

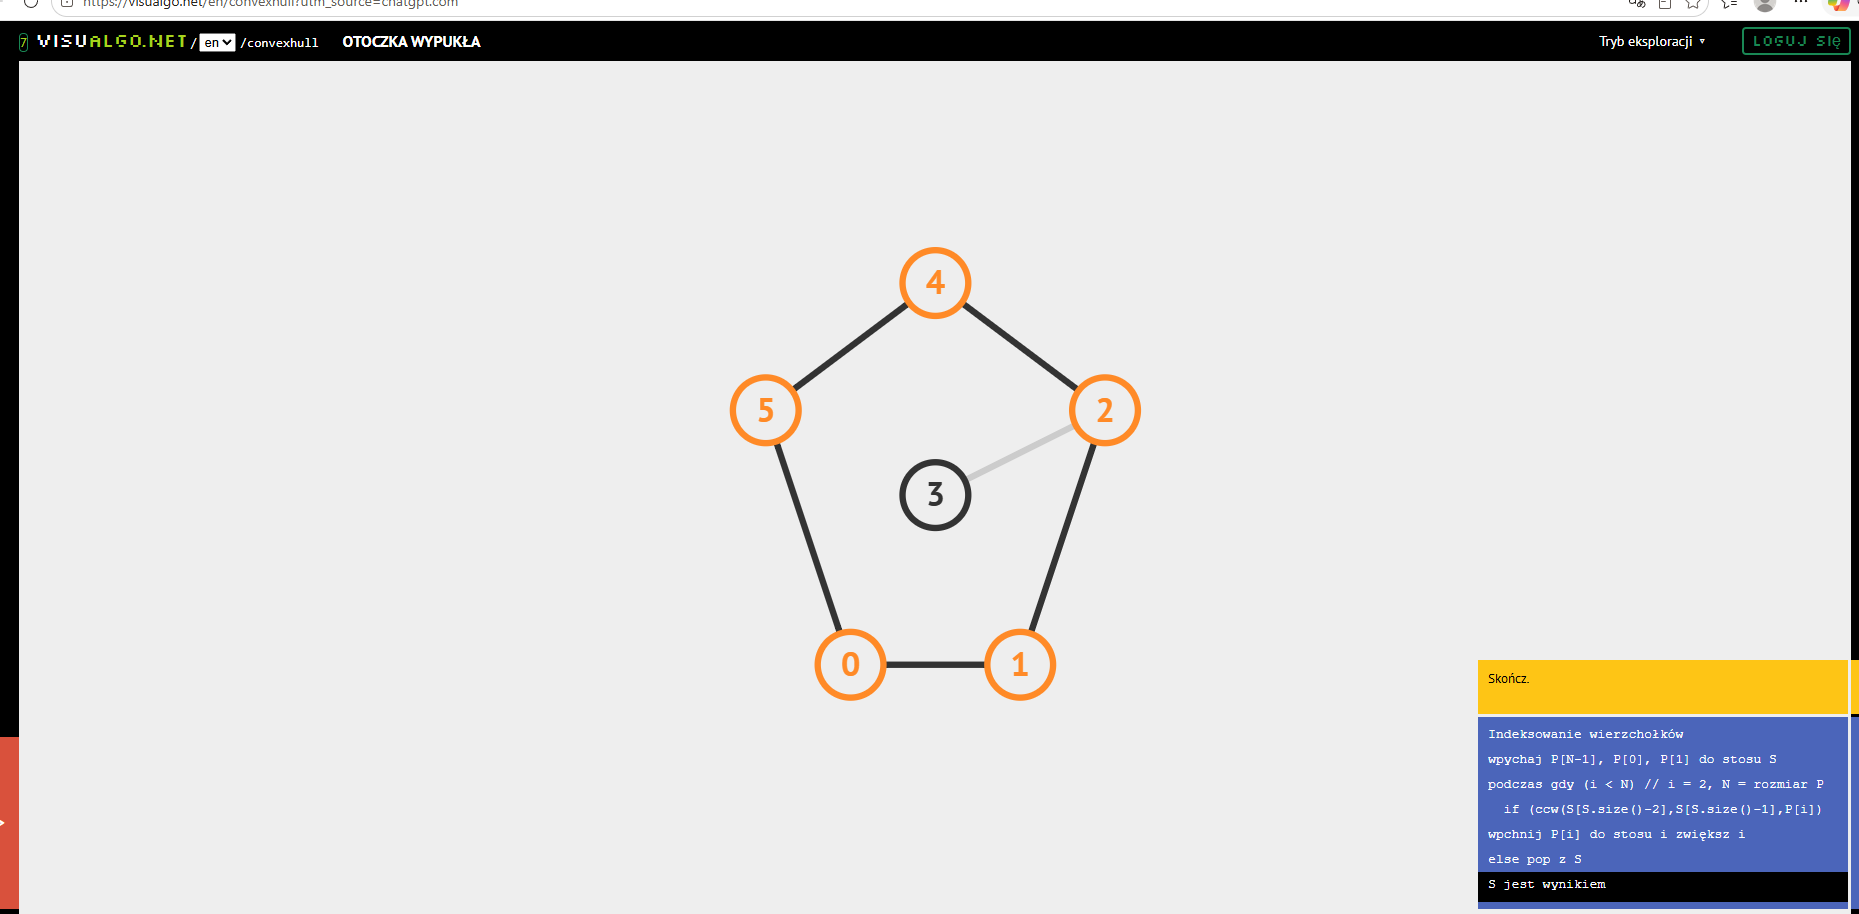
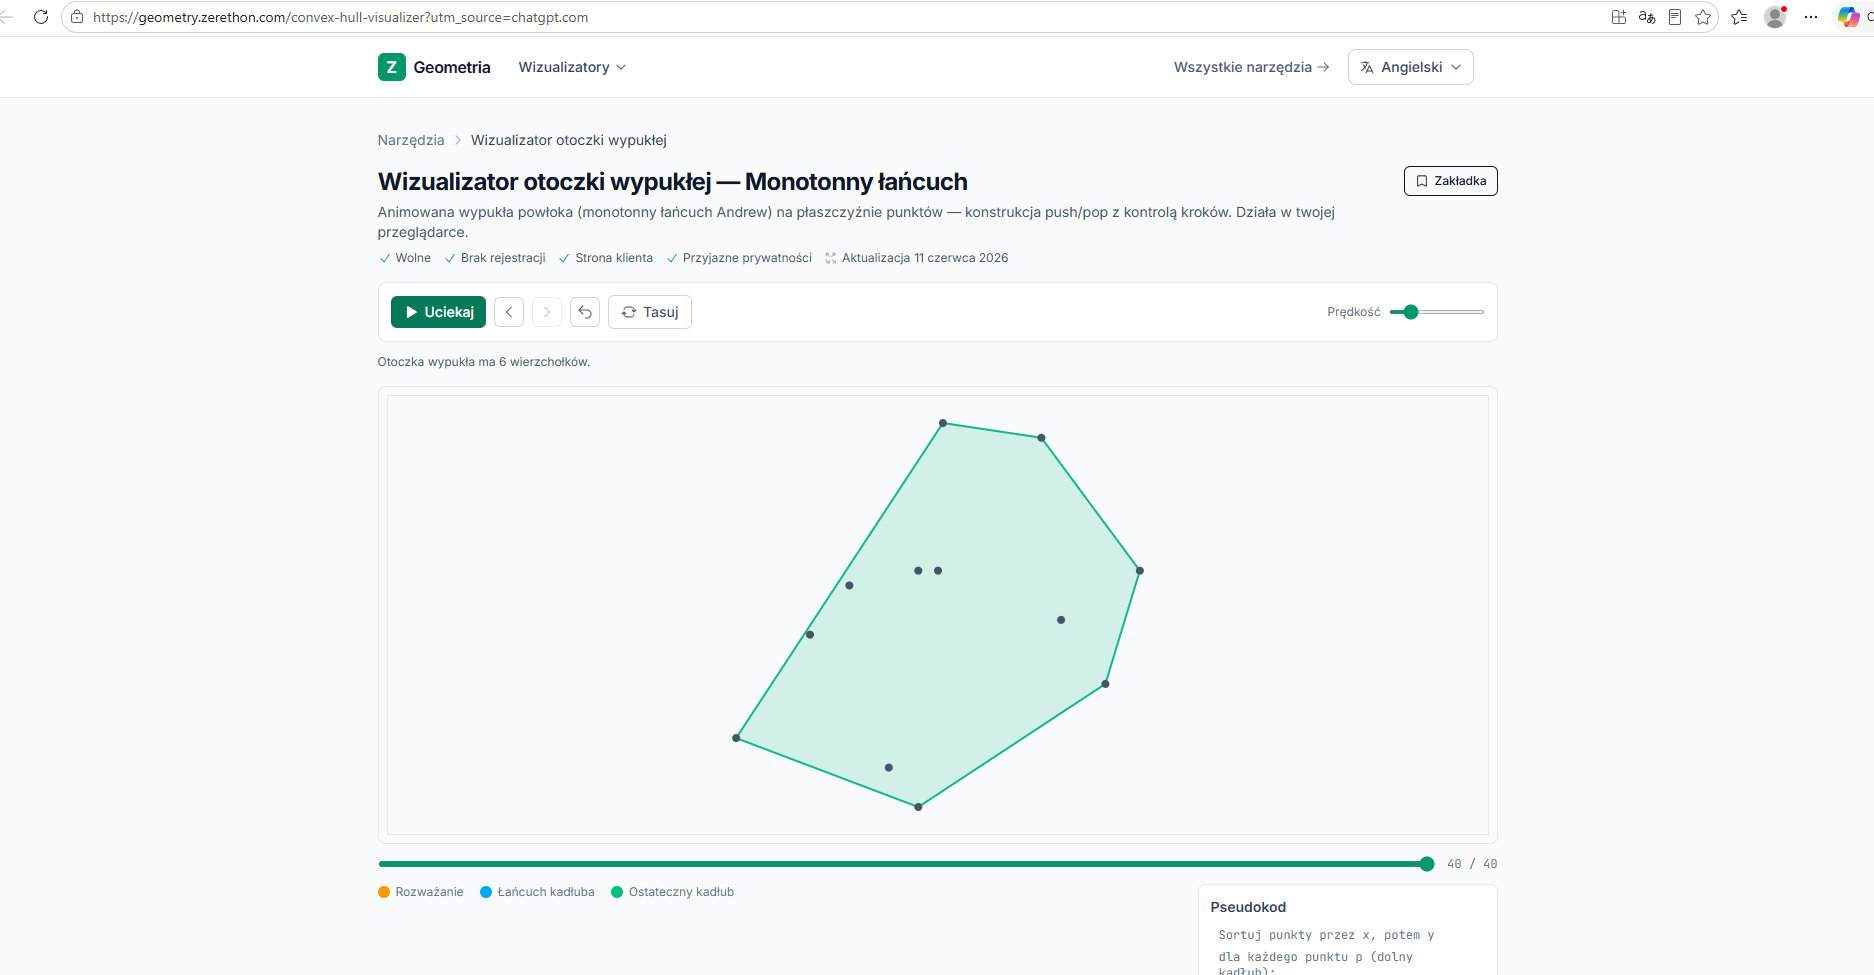
Otoczka wypukła – pojęcie i działanie algorytmu1. Co to jest otoczka wypukła? Otoczka wypukła to najmniejszy wypukły wielokąt, który zawiera wszystkie podane punkty na płaszczyźnie. Można to sobie wyobrazić tak, jakby wokół grupy pinezek wbitych w deskę założyć gumkę recepturkę. Gumka napina się wokół skrajnych pinezek, tworząc otoczkę wypukłą.
Punkty znajdujące się wewnątrz wielokąta nie tworzą jego brzegu. Otoczkę wyznaczają punkty położone najbardziej na zewnątrz.

2. Jak działa algorytm otoczki wypukłej?

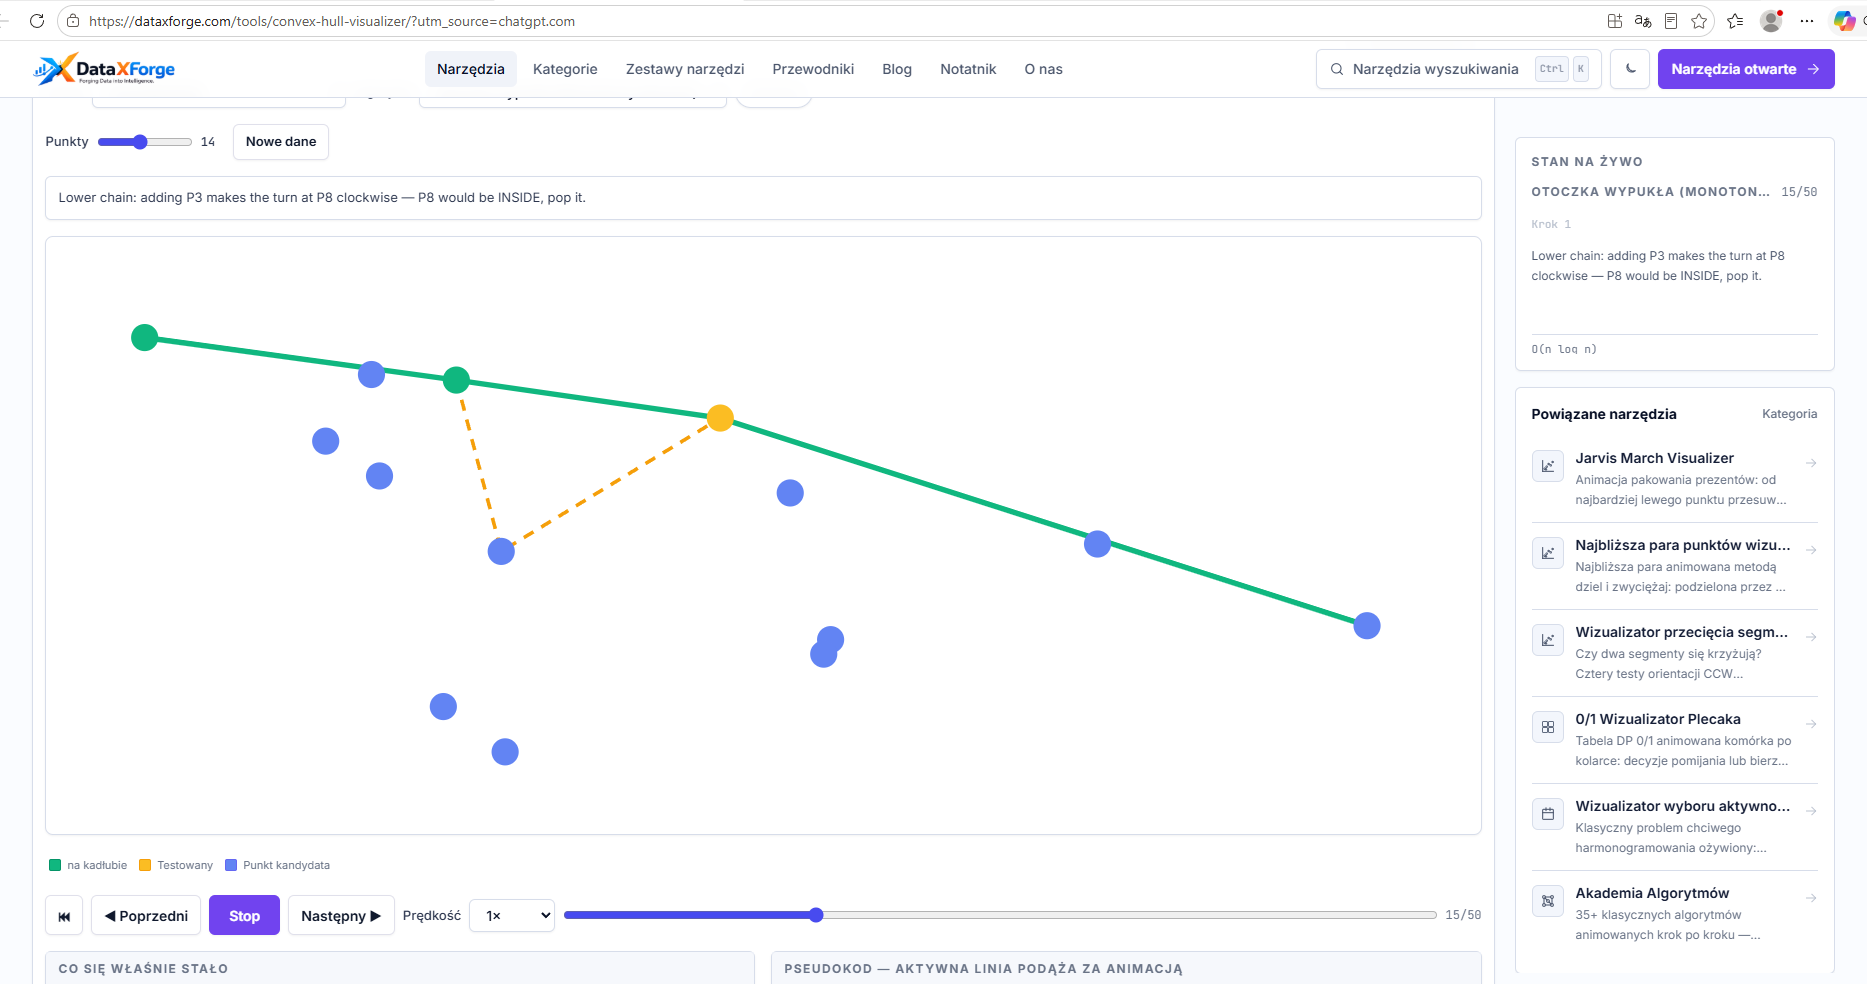
Algorytm otrzymuje zbiór punktów o określonych współrzędnych i wyszukuje te punkty, które tworzą zewnętrzną granicę. W uproszczeniu działa następująco: Wczytuje punkty – każdy punkt ma współrzędne \(x\) i \(y\).Znajduje punkty skrajne – takie, które mogą należeć do zewnętrznej granicy. Wyznacza kolejne krawędzie – łączy odpowiednie punkty odcinkami. Sprawdza kierunek skrętu – ocenia, czy kolejny punkt tworzy prawidłowy, zewnętrzny brzeg wielokąta. Usuwa zbędne punkty z brzegu – jeżeli tworzą wcięcie do środka, algorytm pomija je jako wierzchołki otoczki. Zwraca wynik – uporządkowaną listę punktów tworzących otoczkę wypukłą.


3. Skąd algorytm wie, czy punkt jest we właściwym miejscu?
W jednym z popularnych rozwiązań, na przykład algorytmie monotonicznego łańcucha, wykorzystuje się iloczyn wektorowy. Pozwala on określić, czy przejście przez trzy punkty \(A\), \(B\), \(C\) oznacza skręt w lewo, w prawo czy brak skrętu. Dla współrzędnych punktów obliczamy:\[ s=(B_x-A_x)(C_y-A_y)-(B_y-A_y)(C_x-A_x) \]Jeśli \(s>0\), następuje skręt w lewo. Jeśli \(s<0\), następuje skręt w prawo. Jeśli \(s=0\), punkty leżą na jednej prostej. Na podstawie znaku tej wartości algorytm decyduje, czy zachować punkt jako wierzchołek, czy go pominąć. Dokładna decyzja zależy od sposobu budowania dolnej lub górnej części otoczki.

4. Do czego służy otoczka wypukła?

Wykorzystuje się ją między innymi w grafice komputerowej, robotyce, geografii oraz analizie danych przestrzennych, gdy trzeba znaleźć zewnętrzną granicę zbioru punktów. Najważniejsze do zapamiętania: otoczka wypukła wyznacza zewnętrzny obrys wszystkich punktów. Algorytm sprawdza ich położenie i wybiera te, które tworzą brzeg najmniejszego wypukłego wielokąta zawierającego cały zbiór.


Otoczka wypukła — algorytm Andrew'a w Pythonie1. Co to jest otoczka wypukła? (29.09.2026r.)
Otoczka wypukła (ang. convex hull) to najmniejszy wypukły wielokąt zawierający wszystkie podane punkty.
Można to sobie wyobrazić jako gumkę recepturkę założoną na wszystkie punkty. Punkty, których gumka dotyka, tworzą otoczkę wypukłą.52. Algorytm Andrew'a
Algorytm Andrew'a (Monotone Chain) znajduje otoczkę wypukłą w czasie:
O(n log n)Główne etapy: Sortujemy punkty. Budujemy dolną część otoczki. Budujemy górną część otoczki. Łączymy obie części.3. Iloczyn wektorowy
Najważniejszą operacją jest sprawdzanie, czy trzy punkty tworzą odpowiedni skręt.Dla:A = (x1, y1)
B = (x2, y2)
C = (x3, y3)liczymy:(B.x - A.x) * (C.y - A.y) - \
(B.y - A.y) * (C.x - A.x)Możemy zapisać to jako funkcję: def cross(A, B, C):
return ((B[0] - A[0]) * (C[1] - A[1])
- (B[1] - A[1]) * (C[0] - A[0]))Interpretacja wyniku: cross > 0 → skręt w lewo
cross < 0 → skręt w prawo
cross = 0 → punkty są współliniowe4. Kod w Pythonie def cross(A, B, C):
return ((B[0] - A[0]) * (C[1] - A[1])
- (B[1] - A[1]) * (C[0] - A[0]))


def convex_hull(points):

# 1. Sortowanie punktów
points = sorted(set(points))

# 2. Za mało punktów
if len(points) <= 1:
return points

# 3. Dolna część otoczki
lower = []

for p in points:
while len(lower) >= 2 and cross(lower[-2], lower[-1], p) <= 0:
lower.pop()

lower.append(p)

# 4. Górna część otoczki
upper = []

for p in reversed(points):
while len(upper) >= 2 and cross(upper[-2], upper[-1], p) <= 0:
upper.pop()

upper.append(p)

# 5. Usuwamy powtarzające się końce
return lower[:-1] + upper[:-1]5. Jak działa cross()?Załóżmy:A = (0, 0)
B = (1, 1)
C = (2, 0)Obliczamy:cross(A, B, C)czyli:(1 - 0) * (0 - 0) -
(1 - 0) * (2 - 0)więc:1 * 0 - 1 * 2
= -2Otrzymujemy:-2 < 0czyli punkty tworzą skręt w prawo.
6. Dlaczego używamy while? Najważniejszy fragment: while len(lower) >= 2 and cross(lower[-2], lower[-1], p) <= 0:
lower.pop()Znaczenie:
Dopóki mamy co najmniej dwa punkty i ostatnie trzy punkty tworzą nieprawidłowy skręt, usuwamy ostatni punkt. Przykładowo mamy: A -------- B
\
\
CJeżeli B nie powinien znajdować się na brzegu otoczki, wykonujemy: lower.pop()czyli usuwamy B.Potem sprawdzamy ponownie. Dlatego jest tutaj while, a nie if.7. Dolna część otoczki Punkty są najpierw sortowane: points = sorted(set(points))Następnie przechodzimy od lewej do prawej: for p in points: Dodajemy kolejne punkty: lower.append(p)Przed dodaniem sprawdzamy, czy ostatnie trzy punkty tworzą właściwy skręt: while len(lower) >= 2 and cross(...) <= 0:
lower.pop()W efekcie otrzymujemy dolną część otoczki.8. Górna część otoczkiNastępnie wykonujemy prawie dokładnie to samo:upper = []

for p in reversed(points):Tym razem przechodzimy: od prawej do lewej. Dzięki temu otrzymujemy górną część otoczki.
9. Łączenie Na końcu: return lower[:-1] + upper[:-1]Łączymy: dolna część + górna część[:-1] usuwa ostatni element każdej części, ponieważ te punkty są już początkiem drugiej części.10. Przykład Mamy punkty: points = [
(0, 0),
(1, 1),
(2, 0),
(1, 0),
(0, 2),
(2, 2)
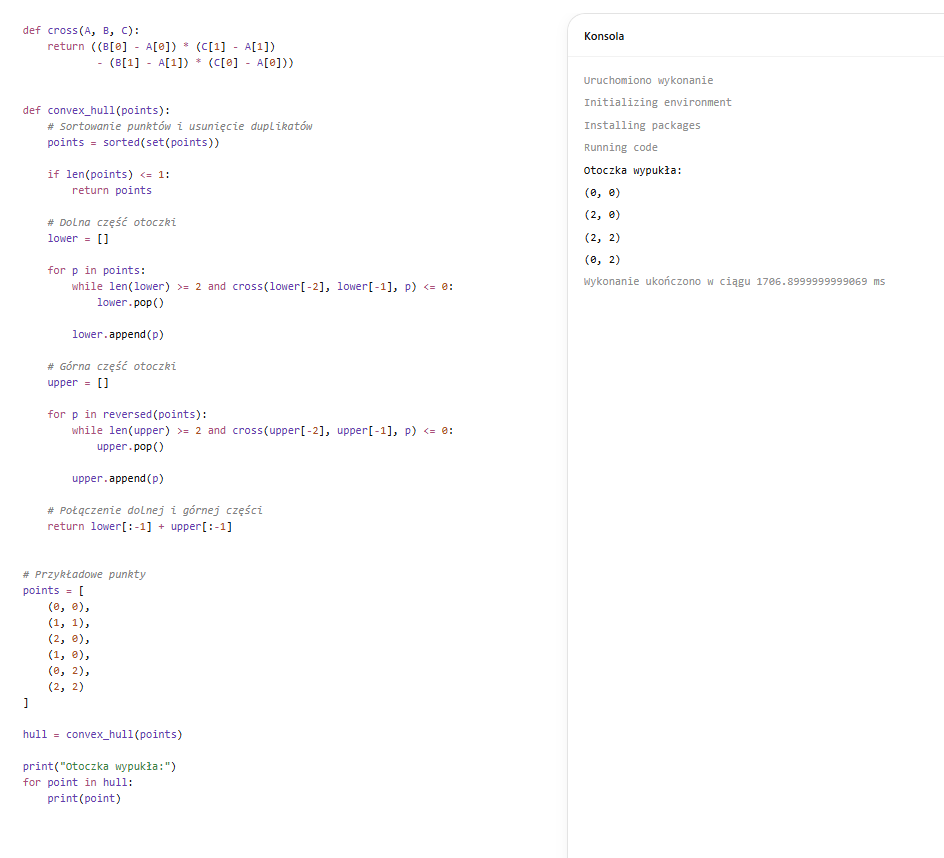
]Wywołujemy: hull = convex_hull(points)

print(hull)Otrzymamy otoczkę składającą się z punktów:(0, 0)
(2, 0)
(2, 2)
(0, 2)Punkty:(1, 0)
(1, 1)nie należą do zewnętrznego brzegu otoczki.11. ZłożonośćNajpierw wykonujemy:sorted(points)Sortowanie:O(n log n)Następnie przechodzimy przez punkty:O(n)Budujemy dwie części:dolna → O(n)
górna → O(n)Całość:O(n log n) + O(n) + O(n)czyli: Złożoność czasowa: O(n log n)Pamięć: Złożoność pamięciowa: O(n)12. Przypadki szczególneBrak punktów[]Jeden punkt[(2, 3)]Dwa punkty[(0, 0), (5, 5)]Punkty współliniowe(0,0) ---- (1,1) ---- (2,2)Przy:cross(...) <= 0punkty znajdujące się pomiędzy skrajnymi zostaną usunięte.13. Co robi set(points)?W kodzie:points = sorted(set(points))set() usuwa duplikaty.Na przykład:[
(0, 0),
(1, 1),
(1, 1),
(2, 0)
]staje się:[
(0, 0),
(1, 1),
(2, 0)
]Następnie sorted() sortuje punkty. Najważniejsze do zapamiętaniaJeżeli masz zapamiętać tylko kilka rzeczy, zapamiętaj:1. Posortuj punkty.

2. Zbuduj dolną część.

3. Zbuduj górną część.

4. Używaj cross() do sprawdzania skrętu.

5. Przy złym skręcie usuń ostatni punkt.

6. Połącz lower i upper.

7. Złożoność: O(n log n).Najważniejsza funkcja:def cross(A, B, C):
return ((B[0] - A[0]) * (C[1] - A[1])
- (B[1] - A[1]) * (C[0] - A[0]))Najważniejszy fragment: while len(lower) >= 2 and cross(lower[-2], lower[-1], p) <= 0:
lower.pop()
To właśnie ten fragment usuwa punkty, które nie należą do otoczki.
Linki do naukiCP-Algorithms — Convex HullWikipedia —
Monotone chain algorithmWikipedia —
Convex hullGeeksforGeeks — Convex Hull
.
Notatka: Tablice i listy wiązane (Arrays & Linked Lists)

1. Tablice (Arrays)

Tablica to struktura danych przechowująca elementy pod kolejnymi indeksami.

  • Indeksowanie zaczyna się od 0.
  • Umożliwia szybki dostęp do elementu o znanym indeksie.
  • Dodawanie elementów może wymagać zwiększenia pojemności tablicy i przeniesienia danych.
  • W wielu językach dostępne są tablice dynamiczne, które automatycznie zwiększają swoją pojemność.

Przykład w Pythonie:

names = ["Anna", "Jan", "Ola"]
print(names[0])  # Anna

2. Listy wiązane (Linked Lists)

Lista wiązana składa się z elementów zwanych węzłami (nodes). Każdy węzeł zawiera:

  • Dane – przechowywaną wartość.
  • Wskaźnik (pointer) – odwołanie do następnego węzła.
  • Elementy nie muszą znajdować się obok siebie w pamięci.
  • Dostęp do konkretnego elementu wymaga przechodzenia od początku listy.
  • Dodawanie elementów nie wymaga przenoszenia wszystkich danych.
  • Węzły potrzebują dodatkowej pamięci na wskaźniki.

3. Porównanie

CechaTablicaLista wiązana
Dostęp do elementu po indeksieSzybki: O(1)Wolniejszy: O(n)
Wyszukiwanie po koleiO(n)O(n)
Dodawanie na końcuZależy od pojemności; zwykle O(1) amortyzowaneO(1), jeśli mamy wskaźnik na koniec
PamięćZwykle mniejszy narzutDodatkowa pamięć na wskaźniki

4. Najważniejsze różnice

  • Tablica: najlepsza, gdy często odczytujemy elementy według indeksu.
  • Lista wiązana: przydatna, gdy często dodajemy lub usuwamy elementy i mamy dostęp do odpowiedniego węzła.
  • Wybór struktury zależy od rodzaju wykonywanych operacji.

Do zapamiętania: tablica zapewnia szybki dostęp po indeksie, a lista wiązana łączy elementy za pomocą wskaźników.

Notatka – przykład grafu (Graph)

1. Jak działa przykład?

Autor przedstawia kilka miejsc połączonych drogami:

  • Home – dom
  • Store A – sklep A
  • Store B – sklep B
  • School – szkoła
  • Intersection – skrzyżowanie

Każde miejsce jest wierzchołkiem (vertex/node), a połączenie między dwoma miejscami to krawędź (edge).

2. Współrzędne miejsc

Każdemu miejscu przypisano współrzędne, np.:

  • Home: (49.2, -123.4)
  • Store A: (49.3, -123.4)
  • Store B: (49.3, -123.3)

Dzięki temu każde miejsce ma określoną lokalizację.

3. Krawędzie grafu

Połączenia pomiędzy miejscami zapisujemy jako pary, np.:

  • (Home, Store A)
  • (Store A, Store B)
  • (Home, Store B)
  • (Store B, School)

Każda para oznacza połączenie pomiędzy dwoma wierzchołkami.

Jeśli graf jest skierowany, kolejność ma znaczenie: (A, B) nie musi oznaczać tego samego co (B, A).

4. Lista sąsiedztwa (Adjacency List)

Graf można zapisać w postaci listy sąsiedztwa. Dla każdego miejsca zapisujemy miejsca, do których można przejść bezpośrednio.

Przykład:

  • Home → Store A, Store B, Intersection
  • Store A → Home, Store B
  • Store B → School
  • School → Store B, Intersection
  • Intersection → School

Taki zapis ułatwia sprawdzanie, jakie połączenia wychodzą z danego miejsca.

5. Jak odczytywać graf?

Jeżeli jesteśmy w Home, możemy przejść bezpośrednio do Store A, Store B lub Intersection.

Jeżeli jesteśmy w Store B, możemy przejść do School.

Nie oznacza to, że można przejść bezpośrednio do dowolnego miejsca na rysunku. Musi istnieć odpowiednia krawędź.

6. Najważniejsze pojęcia

  • Graph (graf) – zbiór wierzchołków i krawędzi.
  • Vertex / Node (wierzchołek) – pojedyncze miejsce.
  • Edge (krawędź) – połączenie między miejscami.
  • Adjacency List (lista sąsiedztwa) – zapis bezpośrednich połączeń każdego wierzchołka.

Do zapamiętania: graf pozwala przedstawiać obiekty i relacje między nimi, np. miasta i drogi, osoby i znajomości albo strony internetowe i linki.

VisuAlgo – notatki z pierwszych 5 tematów

1. Array (Tablica)

Tablica to struktura danych, która przechowuje wiele elementów w określonej kolejności. Każdy element ma swój indeks, czyli numer pozycji, zaczynający się od 0.

Przykład:

 
liczby = [2, 5, 1, 8]
 
  • liczby[0] → 2

  • liczby[1] → 5

  • liczby[2] → 1

  • liczby[3] → 8

Jak działa? Możemy odczytać element bezpośrednio, podając jego indeks. Wstawianie lub usuwanie elementów ze środka może jednak wymagać przesunięcia innych elementów.

Zastosowanie: przechowywanie ocen, liczb, nazw lub innych danych, do których chcemy mieć szybki dostęp.

2. Sorting (Sortowanie)

Sortowanie polega na ustawianiu elementów w określonej kolejności, np. od najmniejszego do największego.

Przykład:

[5, 2, 8, 1] → [1, 2, 5, 8]

Istnieje wiele algorytmów sortowania:

  • Bubble Sort (sortowanie bąbelkowe) – porównuje sąsiednie elementy i zamienia je miejscami, jeśli są w złej kolejności.

  • Selection Sort (sortowanie przez wybieranie) – wyszukuje najmniejszy element i umieszcza go na początku nieposortowanej części.

  • Insertion Sort (sortowanie przez wstawianie) – pobiera kolejne elementy i wstawia je we właściwe miejsce w już uporządkowanej części.

Jak działa? Algorytm wykonuje porównania i ewentualne zamiany elementów, aż uzyska odpowiednią kolejność.

Zastosowanie: porządkowanie wyników, ocen, nazwisk i produktów według ceny.

3. Bitmask (Maska bitowa)

Maska bitowa to sposób zapisywania i przetwarzania informacji przy użyciu bitów, czyli wartości 0 i 1.

Przykład:

1010

Każda pozycja oznacza jeden bit, który może być włączony (1) lub wyłączony (0).

Podstawowe operacje:

  • AND (&) – wynik to 1, gdy oba bity mają wartość 1.

  • OR (|) – wynik to 1, gdy przynajmniej jeden bit ma wartość 1.

  • XOR (^) – wynik to 1, gdy bity są różne.

  • NOT (~) – odwraca bity, zgodnie z reprezentacją liczb w danym języku.

Przykład operacji AND:

 
  1010
& 1100
------
  1000
 

Jak działa? Komputer wykonuje operacje bezpośrednio na poszczególnych bitach. Dzięki temu można efektywnie przechowywać wiele informacji logicznych.

Zastosowanie: przechowywanie ustawień programu, uprawnień użytkowników i sprawdzanie, czy określona flaga jest włączona.

4. Linked List (Lista wiązana)

Lista wiązana składa się z elementów nazywanych węzłami (nodes). Każdy węzeł przechowuje dane oraz wskaźnik do następnego węzła.

Przykład:

10

dane

20

dane

30

koniec (NULL)

Jak działa?

  1. Zaczynamy od pierwszego węzła, zwanego głową (head).

  2. Każdy węzeł wskazuje następny element.

  3. Przechodzimy przez kolejne węzły, aby znaleźć określoną wartość.

  4. Ostatni węzeł wskazuje NULL, czyli brak następnego elementu.

Zalety: łatwe dodawanie i usuwanie elementów, jeśli znamy odpowiednie miejsce.

Wady: aby znaleźć element na konkretnej pozycji, zazwyczaj trzeba przejść przez wcześniejsze węzły. Każdy węzeł potrzebuje też dodatkowej pamięci na wskaźnik.

Zastosowanie: implementacja stosów, kolejek i innych struktur danych.

5. Binary Heap (Kopiec binarny)

Kopiec binarny to struktura danych oparta na drzewie binarnym, w którym każdy węzeł ma najwyżej dwoje dzieci. Spełnia określoną regułę porządku.

Wyróżniamy dwa podstawowe rodzaje:

  • Min-Heap – rodzic ma wartość mniejszą lub równą wartościom swoich dzieci. Najmniejszy element znajduje się na górze.

  • Max-Heap – rodzic ma wartość większą lub równą wartościom swoich dzieci. Największy element znajduje się na górze.

Przykład min-heap:

1

3

5

Jak działa?

  • Dodając element, umieszczamy go na końcu kopca i przesuwamy w górę, jeśli narusza regułę porządku.

  • Usuwając najmniejszy element z min-heap, przenosimy korzeń zastępczym elementem i przesuwamy go w dół, aby przywrócić poprawny układ.

  • Dzięki temu odczytanie najmniejszego lub największego elementu jest bardzo szybkie.

Zastosowanie: kolejki priorytetowe, planowanie zadań i algorytmy wyszukiwania najkrótszych ścieżek.


Podsumowanie

Temat

Najważniejsza cecha

Array

Szybki dostęp do elementów przez indeks

Sorting

Porządkowanie elementów według wybranej reguły

Bitmask

Wykonywanie operacji na bitach 0 i 1

Linked List

Elementy połączone wskaźnikami

Binary Heap

Szybki dostęp do elementu o najwyższym lub najniższym priorytecie

Wniosek: każda struktura i każdy algorytm służą innemu celowi. Dobieramy je w zależności od tego, jakie operacje chcemy wykonywać i jak szybko powinny działać.
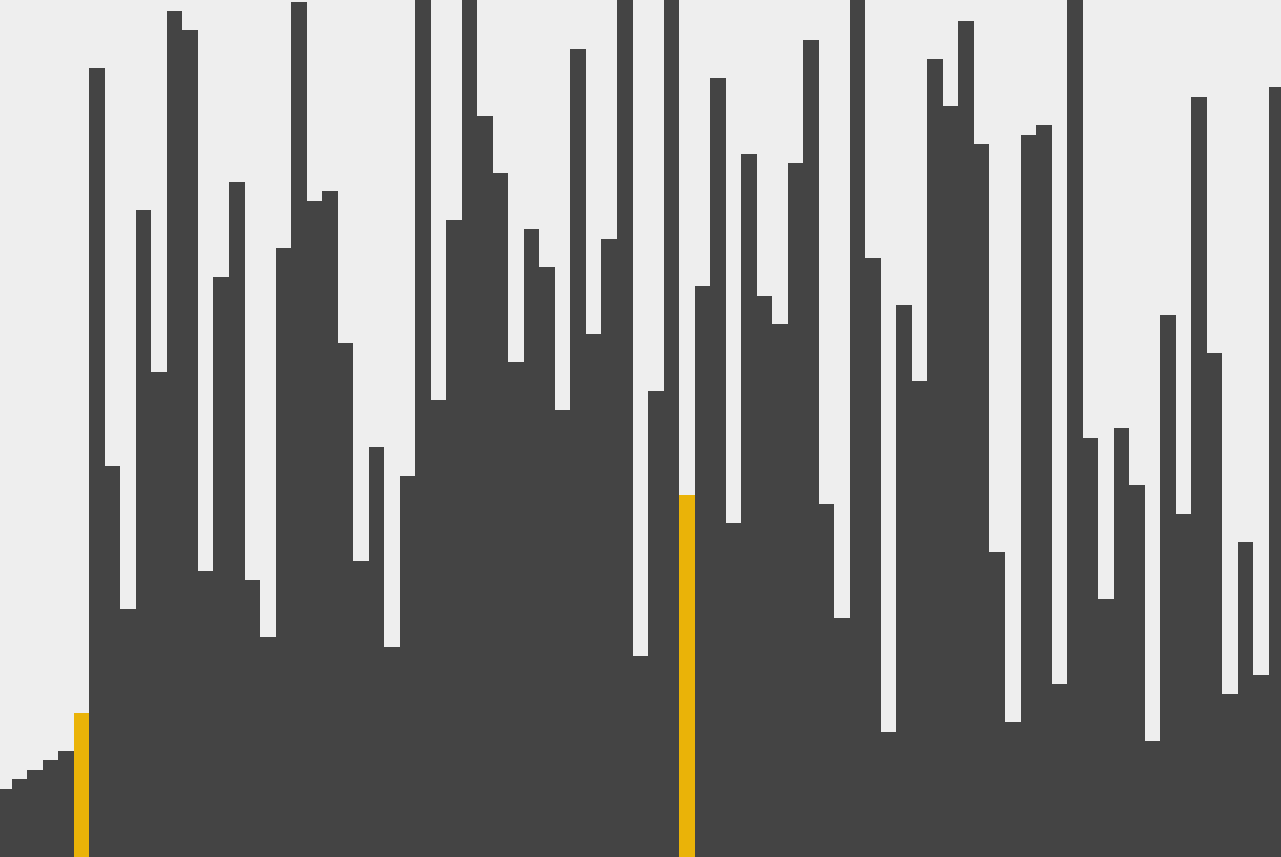
1. Bubble Sort (sortowanie bąbelkowe)
Porównuje dwie sąsiednie liczby i zamienia je miejscami, jeśli są w złej kolejności. Powtarza ten proces, aż wszystkie liczby będą uporządkowane. Przykład: [5, 2, 4] → [2, 4, 5]
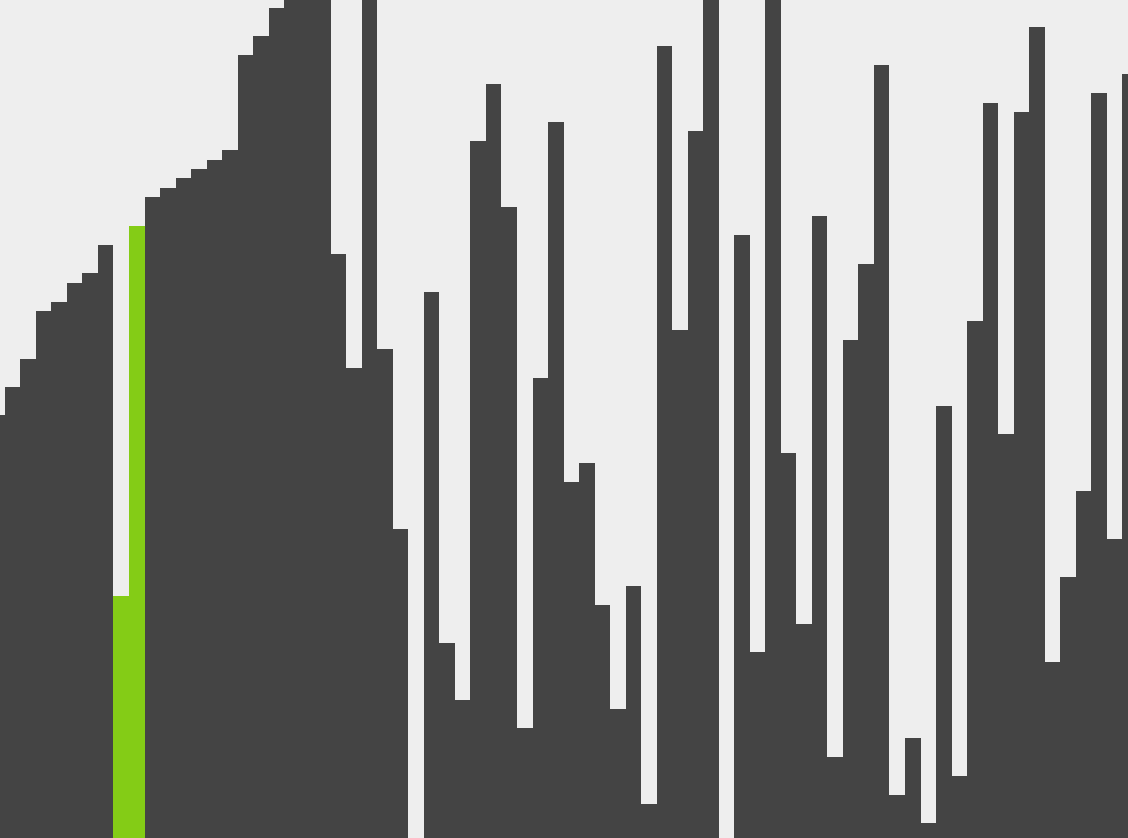
2. Selection Sort (sortowanie przez wybieranie) Wyszukuje najmniejszy element w nieposortowanej części tablicy i umieszcza go na początku tej części. Następnie przechodzi do kolejnego miejsca.
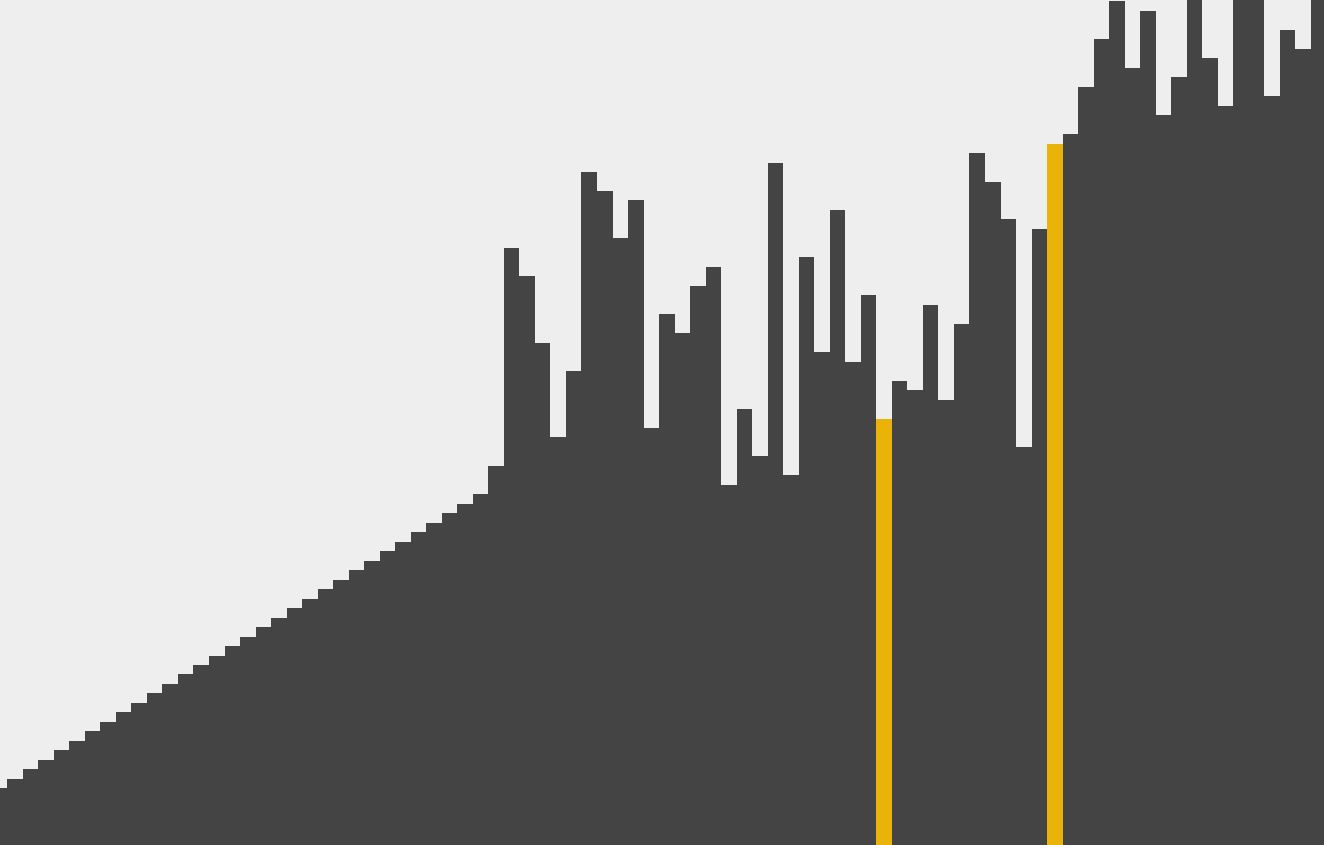
3. Insertion Sort (sortowanie przez wstawianie) Buduje posortowaną część listy. Każdy kolejny element wstawia w odpowiednie miejsce, przesuwając większe elementy w prawo.
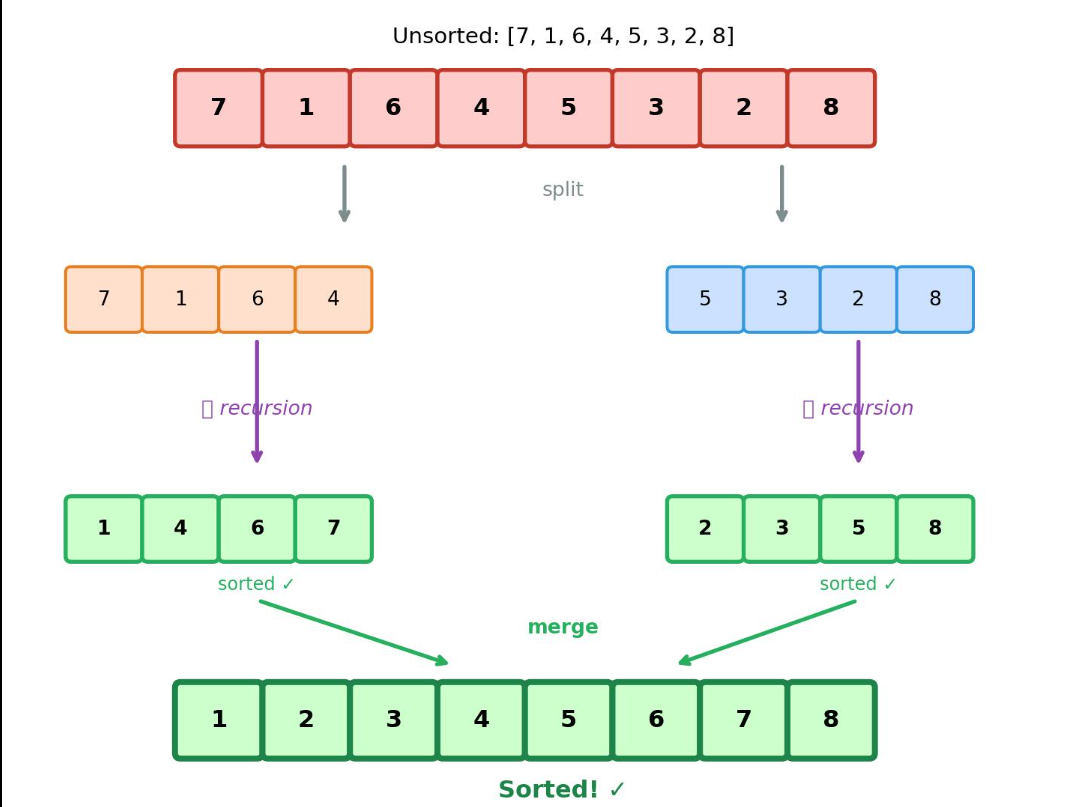
4. Merge Sort (sortowanie przez scalanie) Dzieli listę na mniejsze części, sortuje je, a potem scala w jedną uporządkowaną listę.
5. Quick Sort (sortowanie szybkie) Wybiera element zwany pivotem. Dzieli pozostałe elementy na mniejsze i większe od pivota, a następnie sortuje te części.
6. Heap Sort (sortowanie przez kopcowanie) Tworzy kopiec, czyli specjalną strukturę drzewa. Następnie wielokrotnie pobiera największy element i umieszcza go na końcu listy.
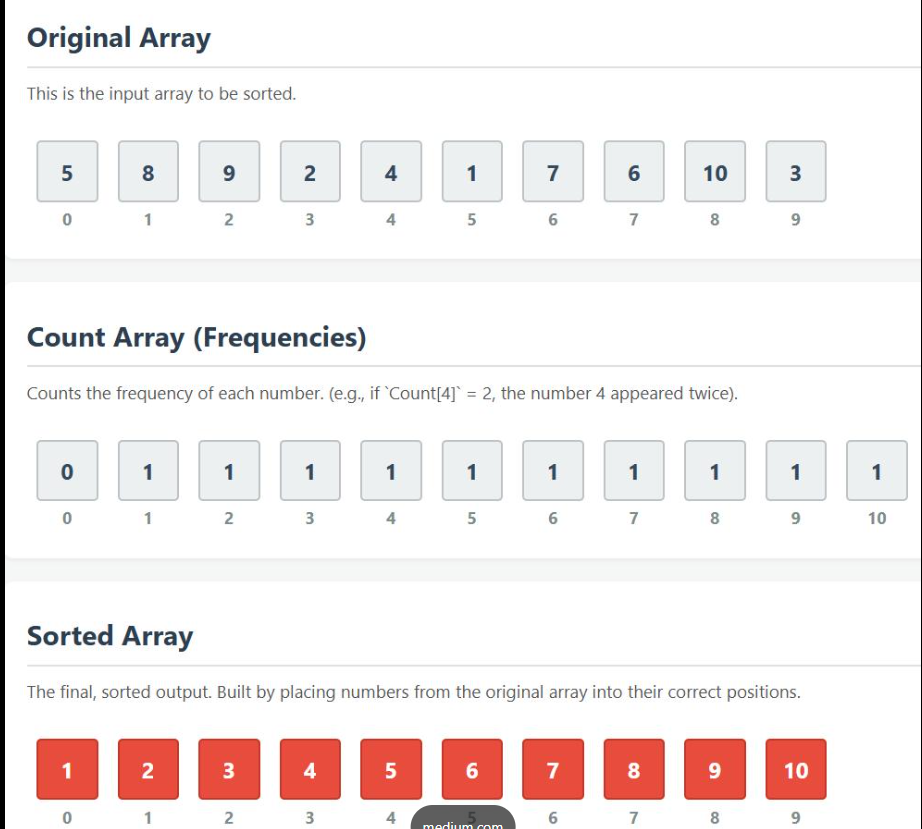
7. Counting Sort (sortowanie przez zliczanie) Zlicza, ile razy występuje każda wartość, a następnie odtwarza listę w odpowiedniej kolejności. Najlepiej działa dla liczb całkowitych z ograniczonego zakresu.
8. Radix Sort (sortowanie pozycyjne) Sortuje liczby według kolejnych cyfr, np. najpierw jedności, potem dziesiątek, a następnie setek.
9. Shell Sort (sortowanie Shella) Porównuje elementy oddalone od siebie o określony odstęp. Stopniowo zmniejsza odstęp, aż wynosi on 1, wykonując końcowe sortowanie przez wstawianie.
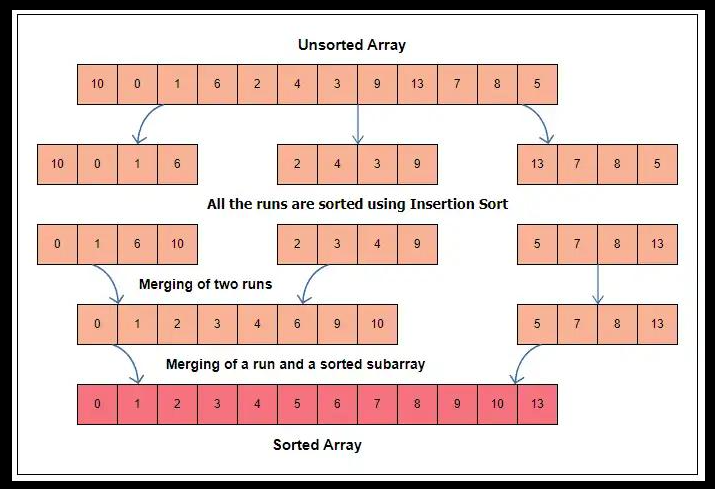
10. Timsort Łączy sortowanie przez wstawianie i scalanie. Wykorzystuje już uporządkowane fragmenty danych, dlatego dobrze sprawdza się w praktyce. Jest stosowany m.in. w Pythonie przy sortowaniu list.
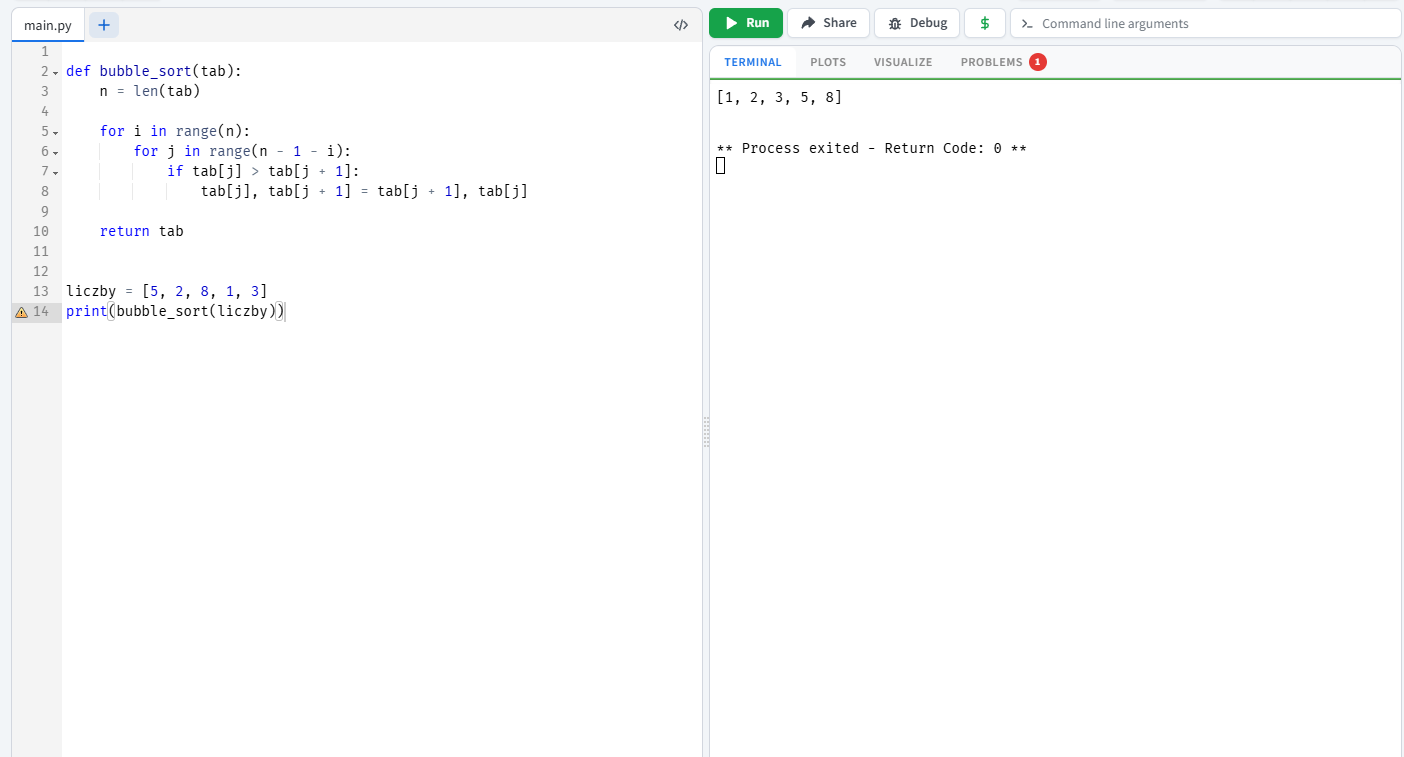
Jak działa kod?
Pętla zewnętrzna określa liczbę przejść.
Pętla wewnętrzna porównuje sąsiednie elementy.
Jeśli lewy element jest większy od prawego, następuje zamiana.
Po każdym przejściu największy z pozostałych elementów trafia na koniec.
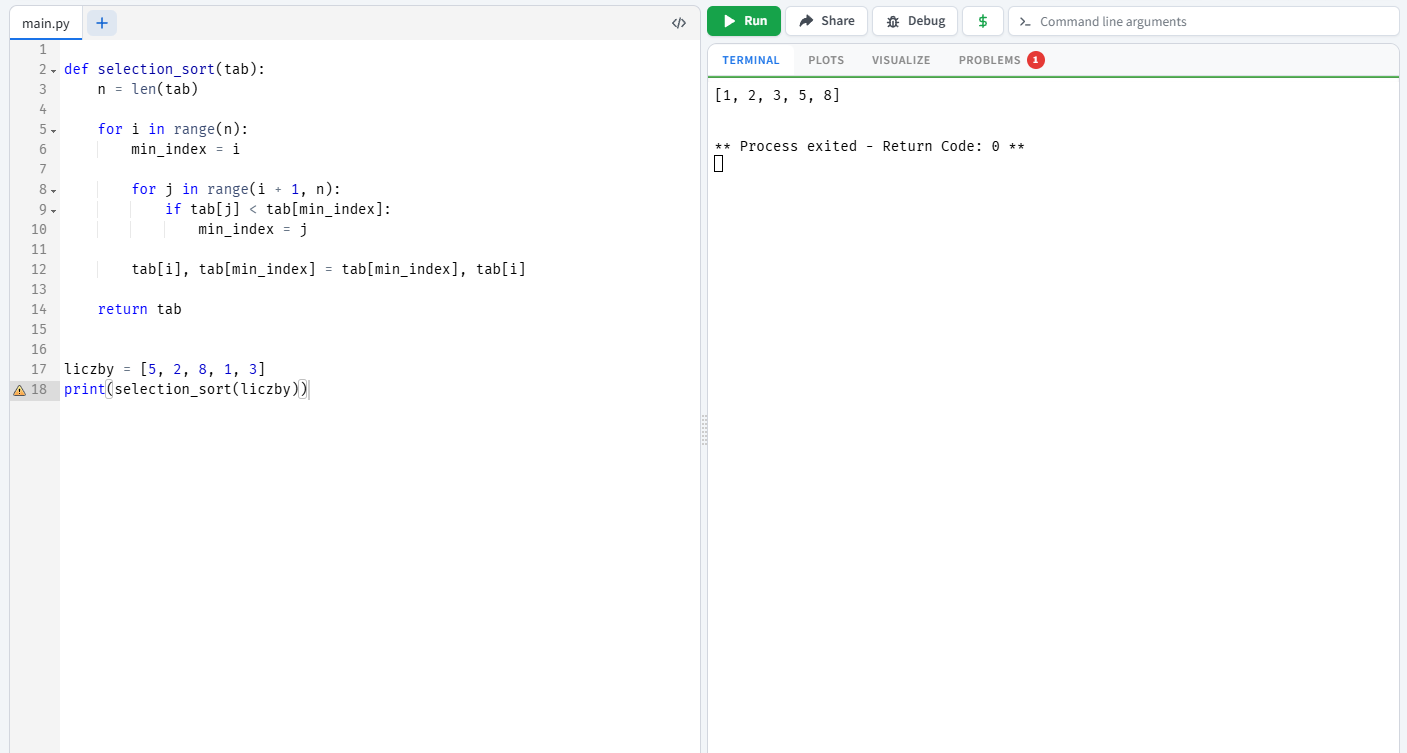
Jak działa kod?
Zakłada, że pierwszy element nieposortowanej części jest najmniejszy.
Szuka mniejszego elementu w dalszej części listy.
Zapamiętuje indeks najmniejszej liczby.
Zamienia najmniejszą liczbę z elementem na aktualnej pozycji.
Powtarza działanie dla kolejnych pozycji.
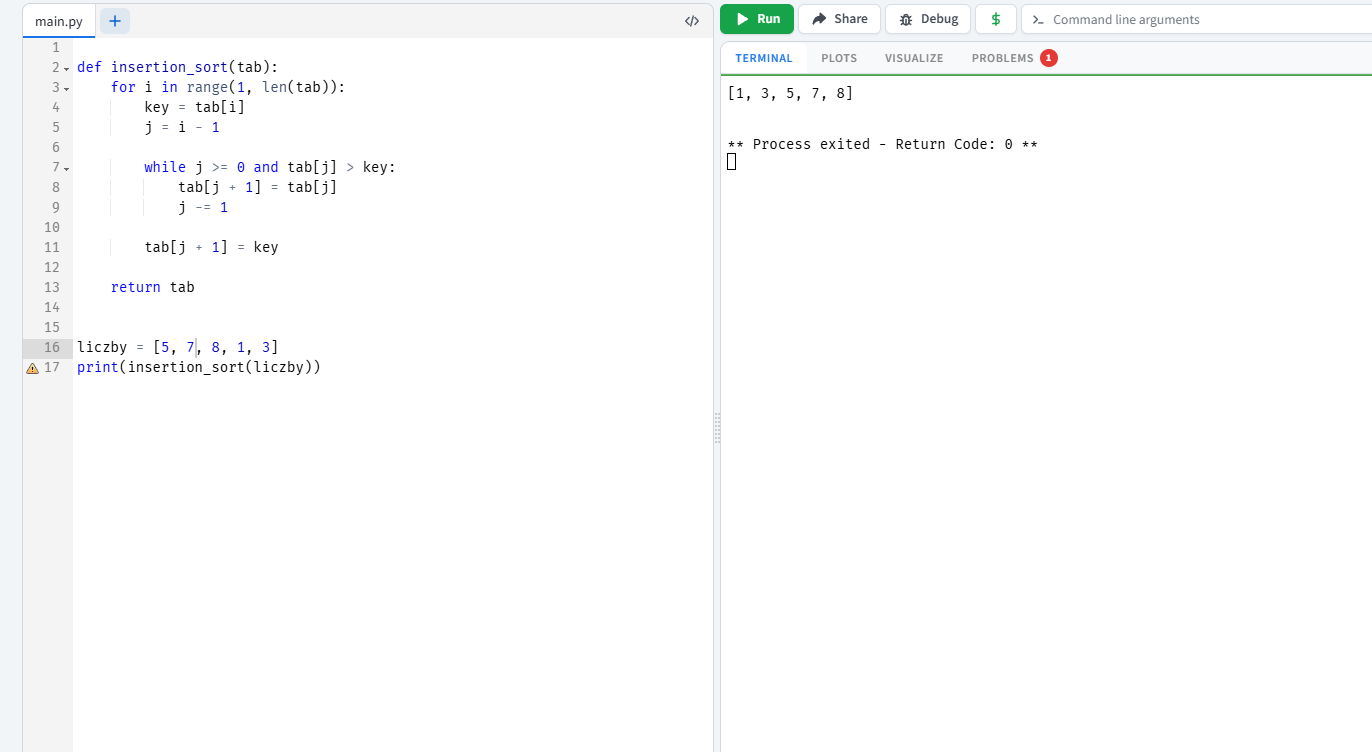
Jak działa kod?
Zaczyna od drugiego elementu listy.
Zapisuje go w zmiennej key.
Przesuwa większe elementy o jedną pozycję w prawo.
Wstawia key w odpowiednie miejsce.
Powtarza operację, aż cała lista będzie posortowana.

Porównanie wszystkich 10 algorytmów

Algorytm

Typowa złożoność

Główna zasada

Bubble Sort

O(n²)

Zamiana sąsiednich elementów

Selection Sort

O(n²)

Wybieranie minimum

Insertion Sort

O(n²)

Wstawianie na właściwe miejsce

Merge Sort

O(n log n)

Dzielenie i scalanie

Quick Sort

O(n log n) średnio

Podział względem pivota

Heap Sort

O(n log n)

Wykorzystanie kopca

Counting Sort

O(n + k)

Zliczanie wartości

Radix Sort

O(d(n + b))

Sortowanie według cyfr

Shell Sort

Zależy od odstępów

Porównywanie odległych elementów

Timsort

O(n log n)

Łączenie wstawiania i scalania

1. Co oznaczają symbole?

  • n – liczba elementów do posortowania, np. 5 liczb oznacza n=5.

  • k – zakres wartości lub liczba możliwych wartości, np. dla liczb od 0 do 99 zakres ma 100 wartości, więc k=100.

  • log n – logarytm; w tych przykładach można go rozumieć jako liczbę kolejnych podziałów danych na połowy.

  • O(…) – zapis określający, jak rośnie ilość pracy algorytmu wraz ze wzrostem danych. Nie oznacza dokładnego czasu w sekundach.

2. Najważniejsze wzory na przykładach

Załóżmy, że sortujemy 100 elementów, czyli n=100.

O(1) – stała złożoność

Wykonanie operacji zajmuje podobną ilość pracy niezależnie od liczby elementów.

Przykład: odczytanie elementu listy po jego indeksie.

O(n) – liniowa

Praca rośnie proporcjonalnie do liczby elementów.

Dla n=100: około 100 operacji.

Dla n=1000: około 1000 operacji.

O(n²) – kwadratowa

Liczba operacji rośnie mniej więcej jak liczba elementów pomnożona przez samą siebie.

Dla n=100: około 10 000 operacji.

Dla n=1000: około 1 000 000 operacji.

Przykłady: Bubble Sort, Selection Sort i w najgorszym przypadku Insertion Sort.

O(n log n) – liniowo-logarytmiczna

Algorytm wykonuje pracę proporcjonalną do n razy log⁡n. Zwykle skaluje się znacznie lepiej niż O(n²).

Dla n=100: około 664 jednostek pracy, jeśli przyjmiemy log⁡2(100).

Przykłady: Merge Sort i Heap Sort; Quick Sort średnio.

O(n + k) – liniowa względem danych i zakresu

Dodajemy liczbę elementów i rozmiar zakresu wartości.

Dla n=100 i k=100: około 200 jednostek pracy.

Przykład: Counting Sort.

Podane liczby to orientacyjne wartości funkcji opisujących wzrost pracy, a nie rzeczywiste liczby operacji każdego programu.

Jak rozumieć wzory z tabeli 10 sortowań?

Zapis

Znaczenie

Algorytmy

O(n²)

Dla dużych list robi się wolny

Bubble, Selection, Insertion (najgorzej)

O(n log n)

Dobrze radzi sobie z dużymi listami

Merge, Heap, Quick (średnio), Timsort (najgorzej)

O(n + k)

Zależy od liczby elementów i zakresu wartości

Counting

O(d(n + b))

Zależy od liczby cyfr i podstawy systemu

Radix

Zależy od odstępów

Wydajność zależy od sposobu zmniejszania odstępów

Shell

10.11.2026r.

temat: Projektowanie algorytmu i tworzenie własnego programu.
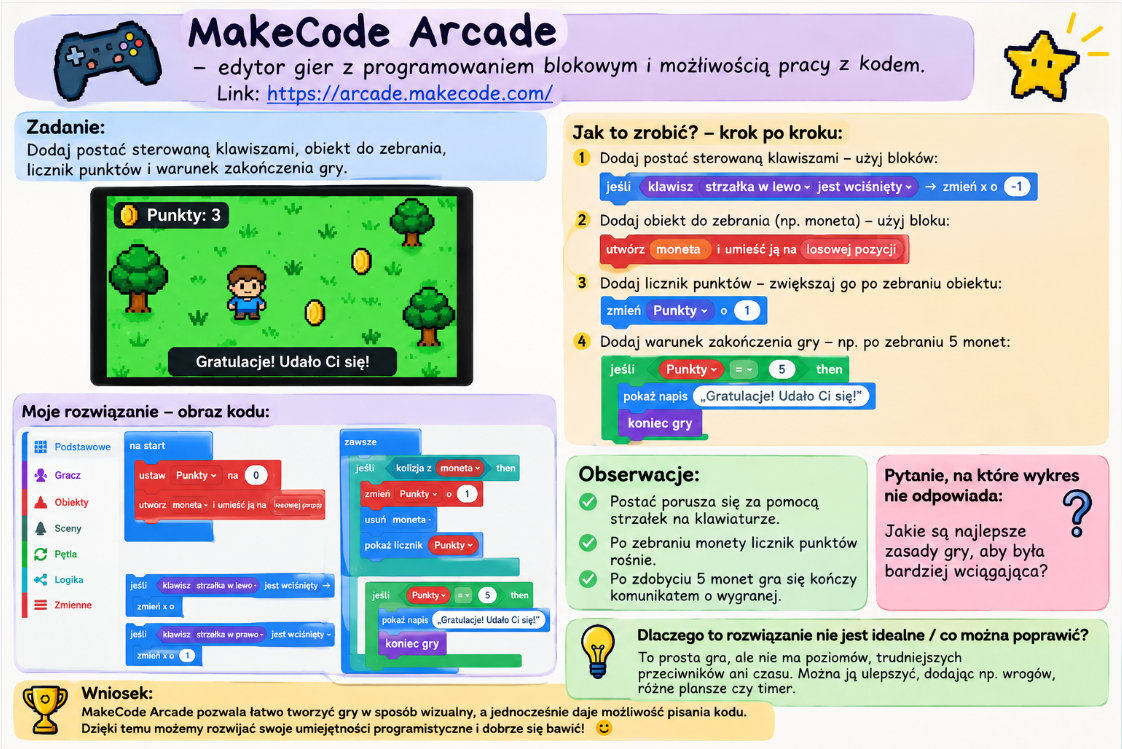
MakeCode Arcade – tworzenie własnej gry

Gotowa notatka do zeszytu

Opis narzędzia: MakeCode Arcade to edytor służący do tworzenia gier komputerowych. Umożliwia programowanie za pomocą kolorowych bloków oraz pisanie kodu.

Link: https://arcade.makecode.com/

1. Moja gra – zbieranie monet

Cel gry:
Sterować postacią za pomocą klawiszy strzałek i zbierać monety. Za każdą zebraną monetę gracz otrzymuje 1 punkt. Po zebraniu 5 monet gra się kończy i wyświetla komunikat o wygranej.
2. Jak wykonać grę – krok po krokuMakeCode Arcade Lesson Two: Collision and Scoring with Fruit Catcher – Joylabz Official Makey Makey StoreKrok 1. Dodanie postaci Wybieram kategorię „Sprites”.Tworzę postać gracza. W kategorii „Controller” wybieram blok „move mySprite with buttons”.Dzięki temu postać porusza się strzałkami na klawiaturze.2D Sidescrolling Platformer with MakeCode Arcade | Little Bird ElectronicsKrok 2. Dodanie monety W kategorii „Sprites” tworzę nowy obiekt. Wybieram obraz monety. Ustawiam ją na planszy jako przedmiot do zebrania. Programa tus juegos con Makecode Arcade · academy.botKrok
3. Licznik punktów W kategorii „Info” wybieram „set score to 0”.Po zebraniu monety używam „change score by 1”.Licznik pokazuje zdobyte punkty.On overlap - AP CS Principles - Microsoft MakeCodeKrok
4. Zakończenie gry Dodaję warunek „if score = 5”.Jeśli gracz zbierze 5 monet, wyświetla się komunikat „Gratulacje! Wygrałeś!”.Następnie gra kończy się blokiem „game over win”.

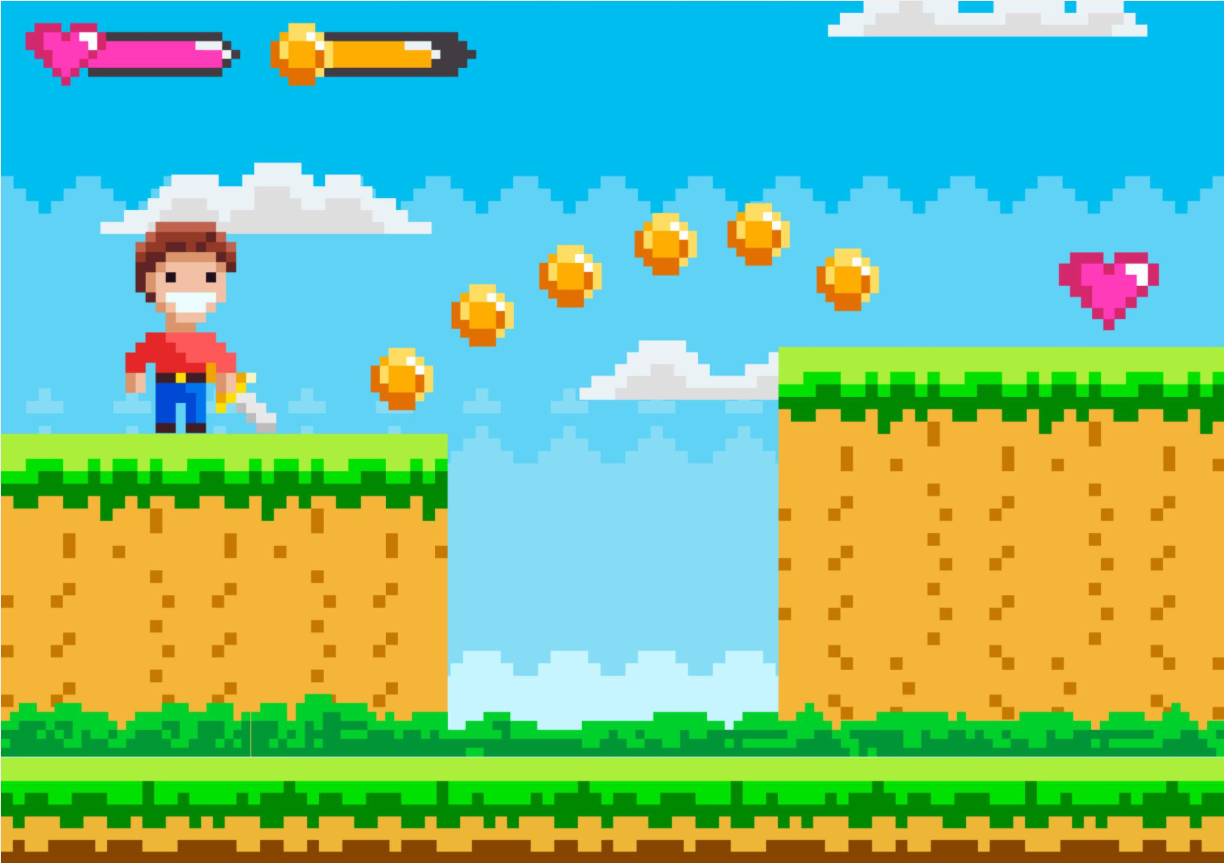
4. Tak wygląda przykładowy efekt końcowy
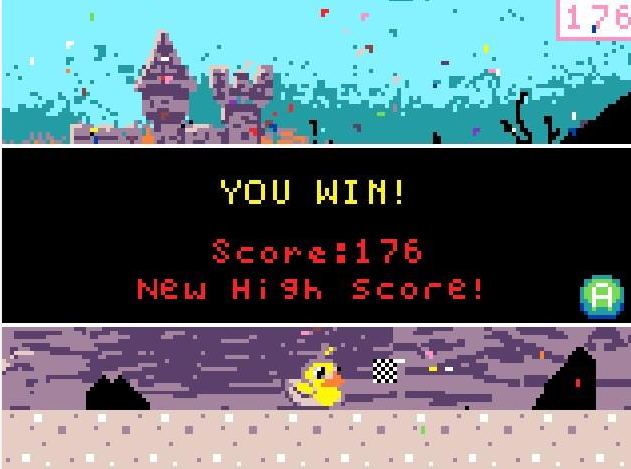
5. Obserwacje

  1. Postać porusza się za pomocą klawiszy strzałek.

  2. Na planszy znajduje się moneta, którą można zebrać.

  3. Po zebraniu monety licznik punktów zwiększa się o jeden.

  4. Po uzyskaniu 5 punktów gra automatycznie się kończy.

  5. Programowanie blokowe pozwala łatwo połączyć poszczególne elementy gry.

6. Pytanie, na które gra nie odpowiada

Jak sprawić, aby gra była ciekawsza i miała różne poziomy trudności?

Gra nie podpowiada sama, jakie przeszkody, zasady i dodatkowe elementy najlepiej dodać. To zależy od pomysłu autora.

7. Co można ulepszyć?

  • Dodać więcej poziomów.

  • Dodać przeciwników.

  • Wprowadzić limit czasu.

  • Dodać dźwięki podczas zbierania monet.

  • Zmienić wygląd postaci i planszy.

8. Wniosek

MakeCode Arcade pozwala tworzyć własne gry komputerowe bez konieczności posiadania dużej wiedzy programistycznej. Dzięki kolorowym blokom można sterować postacią, zbierać przedmioty, zdobywać punkty i ustalać warunki zakończenia gry. Program rozwija kreatywność, logiczne myślenie i umiejętności programowania.


Materiały pomocnicze:

Blockly Games – instrukcje warunkowe, pętle i logiczne planowanie 
Opis narzędzia: Blockly Games to zestaw edukacyjnych gier, które uczą podstaw programowania.
Dzięki układaniu kolorowych bloków można sterować postacią, rozwiązywać labirynty i wykonywać zadania.
Program pomaga ćwiczyć instrukcje warunkowe, pętle oraz logiczne myślenie.

Link:
https://blockly.games/
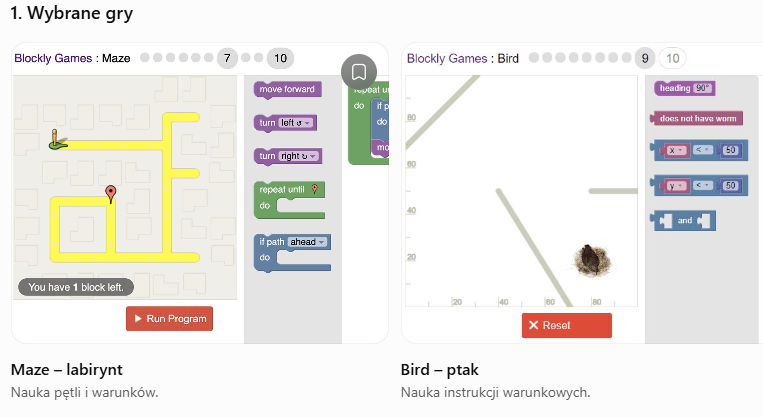
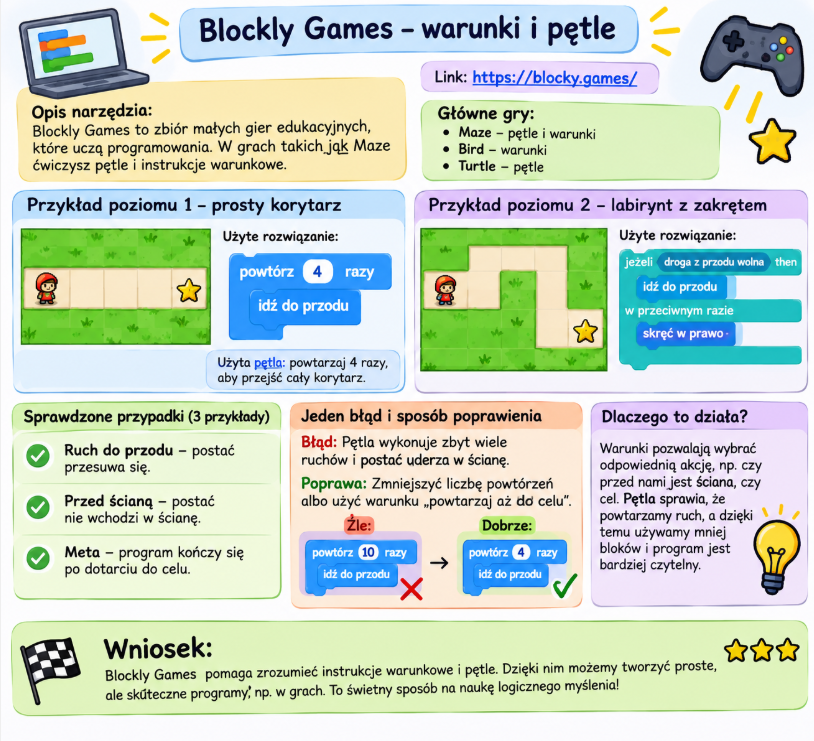
2. Rozwiązanie dwóch przykładowych poziomów [Maze-labirynt]

Poziom 1 – przejście prostego korytarza

  • Zadanie: doprowadzić postać do mety.

  • Użyte rozwiązanie: pętla „powtórz 4 razy”.

  • Wewnątrz pętli znajduje się instrukcja „idź do przodu”.

  • Dzięki pętli nie trzeba kilka razy dodawać tego samego bloku.

Poziom 2 – labirynt z zakrętem
 
  • Zadanie: przejść labirynt i dotrzeć do celu.

  • Użyty warunek: „jeżeli droga z przodu jest wolna”.

  • Jeżeli droga jest wolna, postać idzie do przodu.

  • W przeciwnym razie wykonuje skręt.

Przykład:

Użyty warunek

JEŻELI droga z przodu jest wolna

IDŹ DO PRZODU

W PRZECIWNYM RAZIE

SKRĘĆ W PRAWO

3. Sprawdzenie trzech przypadków

Przypadek

Wynik sprawdzenia

Ruch do przodu

Poprawnie

Postać przesuwa się do przodu.

Brak kolizji

Poprawnie

Postać nie wchodzi w ścianę.

Dotarcie do mety

Poprawnie

Program kończy działanie po osiągnięciu celu.

Uwaga: w grze Maze nie ma typowego licznika punktów, dlatego sprawdzamy ruch, unikanie ścian i dotarcie do mety.

4. Jeden błąd i sposób jego poprawienia

BŁĄD

Za duża liczba powtórzeń

Pętla wykonuje zbyt wiele ruchów, przez co postać może uderzyć w ścianę.

Źle: powtórz 10 razy.

 
POPRAWA

Zmniejszenie liczby powtórzeń

Dobrze: powtórz 4 razy (jeśli taka liczba ruchów prowadzi do mety).

Można też zastosować warunek „powtarzaj aż do celu”.

5. Dlaczego to działa?

  • Instrukcja warunkowa pozwala programowi podejmować decyzje.

  • Pętla pozwala wielokrotnie wykonywać te same czynności.

  • Dzięki nim można tworzyć krótsze i bardziej uporządkowane programy.

  • Przed wykonaniem ruchu można sprawdzić, czy droga jest wolna.

6. Wniosek

Blockly Games pomaga zrozumieć podstawy programowania. Podczas rozwiązywania labiryntów uczymy się stosować pętle i instrukcje warunkowe. Dzięki temu rozwijamy logiczne myślenie, cierpliwość i umiejętność rozwiązywania problemów.


10.11.2026r.
Temat: Rozbudowa programu, testy i prezentacja rozwiązania.

Lorem ipsum dolor sit amet, consectetur adipiscing elit. Ut elit tellus, luctus nec ullamcorper mattis, pulvinar dapibus leo.

17.11.2026r.

Algorytm zachłanny (lokalny) – wprowadzenie, definicja i przykłady

1. Wprowadzenie – czym jest algorytm zachłanny?

Algorytm zachłanny (ang. Greedy Algorithm) to sposób rozwiązywania problemów algorytmicznych, w którym podejmujemy decyzje krok po kroku, za każdym razem wybierając rozwiązanie, które w danym momencie wydaje się najlepsze.

Oznacza to, że algorytm nie analizuje wszystkich możliwych rozwiązań ani nie przewiduje dokładnie, jakie skutki przyniesie dana decyzja w przyszłości. Zamiast tego skupia się na aktualnej sytuacji i wybiera najlepszą dostępną możliwość.

Takie podejście nazywamy strategią zachłanną, ponieważ algorytm za każdym razem stara się uzyskać jak największą korzyść lub najmniejszy koszt w danym kroku.

Algorytmy zachłanne są często stosowane w problemach związanych z:

  • optymalizacją kosztów,

  • wyborem najlepszych elementów ze zbioru,

  • planowaniem i organizacją zadań,

  • wyszukiwaniem najkrótszych lub najtańszych rozwiązań,

  • zarządzaniem zasobami.

Czym jest lokalny algorytm zachłanny?

Algorytm zachłanny lokalny podejmuje decyzje na podstawie aktualnej sytuacji, bez analizowania całego problemu.

Słowo „lokalny” oznacza, że algorytm wybiera najlepszą możliwość spośród tych, które są dostępne w danym momencie. Nie musi to jednak oznaczać, że ostateczny wynik będzie najlepszy z możliwych.

Przykład: Wyobraźmy sobie, że chcemy przejść przez labirynt. Na każdym skrzyżowaniu wybieramy drogę, która wygląda na najkrótszą. Nie sprawdzamy jednak, czy za zakrętem nie znajduje się ślepa uliczka. Może się więc okazać, że lokalnie najlepsza decyzja doprowadzi nas do gorszego wyniku końcowego.

2. Definicja algorytmu zachłannego

Algorytm zachłanny to algorytm, który konstruuje rozwiązanie problemu etapami, podejmując w każdym etapie decyzję optymalną z punktu widzenia aktualnej sytuacji, bez cofania się i zmieniania wcześniej podjętych decyzji.

Najważniejsze cechy algorytmów zachłannych:

  1. Podejmowanie decyzji lokalnych – w każdym kroku wybierana jest najlepsza aktualnie dostępna opcja.

  2. Brak cofania się – algorytm nie wraca do poprzednich decyzji, nawet jeśli później okażą się niekorzystne.

  3. Stopniowe budowanie rozwiązania – wynik powstaje poprzez dodawanie kolejnych elementów.

  4. Prostota i szybkość – często są prostsze i szybsze od metod sprawdzających wszystkie możliwe rozwiązania.

  5. Brak gwarancji najlepszego wyniku – nie każdy algorytm zachłanny znajduje rozwiązanie globalnie optymalne.

Warto pamiętać, że algorytm zachłanny daje rozwiązanie optymalne tylko wtedy, gdy problem ma odpowiednie własności matematyczne, takie jak własność wyboru zachłannego i optymalna podstruktura.

3. Cztery przykłady algorytmów zachłannych – dokładna analizaPrzykład

1. Wydawanie reszty – problem monet
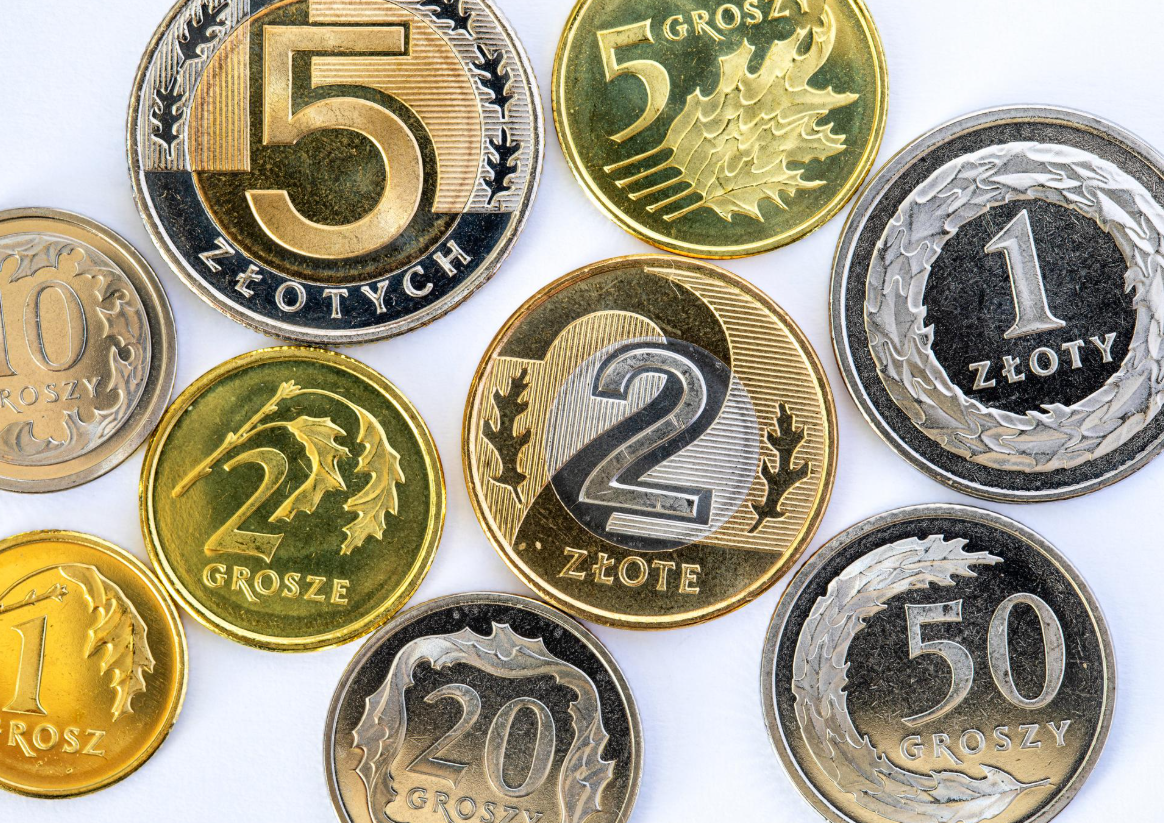
Opis problemu: Mamy za zadanie wydać klientowi resztę w wysokości 18 zł. Dysponujemy monetami i banknotami o nominałach:10 zł,5 zł,2 zł,1 zł. Chcemy wydać resztę, używając jak najmniejszej liczby monet i banknotów. 
Zasada działania algorytmu zachłannego: Algorytm zawsze wybiera największy nominał, który nie przekracza aktualnej kwoty pozostałej do wydania. 
Analiza krok po kroku: Krok Pozostała kwota Wybrany nominał118 zł10 zł28 zł5 zł33 zł2 zł41 zł1 zł50 zł Koniec 
Otrzymane rozwiązanie 4 elementy łącznie10 zł 5 zł 2 zł 1 zł10 + 5 + 2 + 1 = 18 zł 
Dokładna analiza: Na początku algorytm wybiera 10 zł, ponieważ jest to największy nominał, który mieści się w kwocie 18 zł. Pozostaje 8 zł, więc wybiera 5 zł. Następnie pozostają 3 zł, dlatego wybiera 2 zł. Na końcu pozostaje 1 zł i algorytm dobiera ostatnią monetę. Po wydaniu całej kwoty algorytm kończy działanie. 
Dlaczego jest to algorytm zachłanny? Ponieważ na każdym etapie wybiera największy możliwy nominał, nie zastanawiając się nad innymi kombinacjami monet. 
Ważna uwaga: Ta metoda nie zawsze daje najlepszy wynik. Przykładowo dla nominałów 1, 3 i 4 oraz kwoty 6 algorytm wybierze 4 + 1 + 1, czyli 3 monety. Tymczasem lepszym rozwiązaniem jest 3 + 3, czyli tylko 2 monety. Wniosek: algorytm zachłanny działa optymalnie dla standardowego systemu polskich nominałów, ale nie dla każdego dowolnego zestawu monet.
Przykład 2. Problem wyboru aktywności (Activity Selection Problem)

Opis problemu:

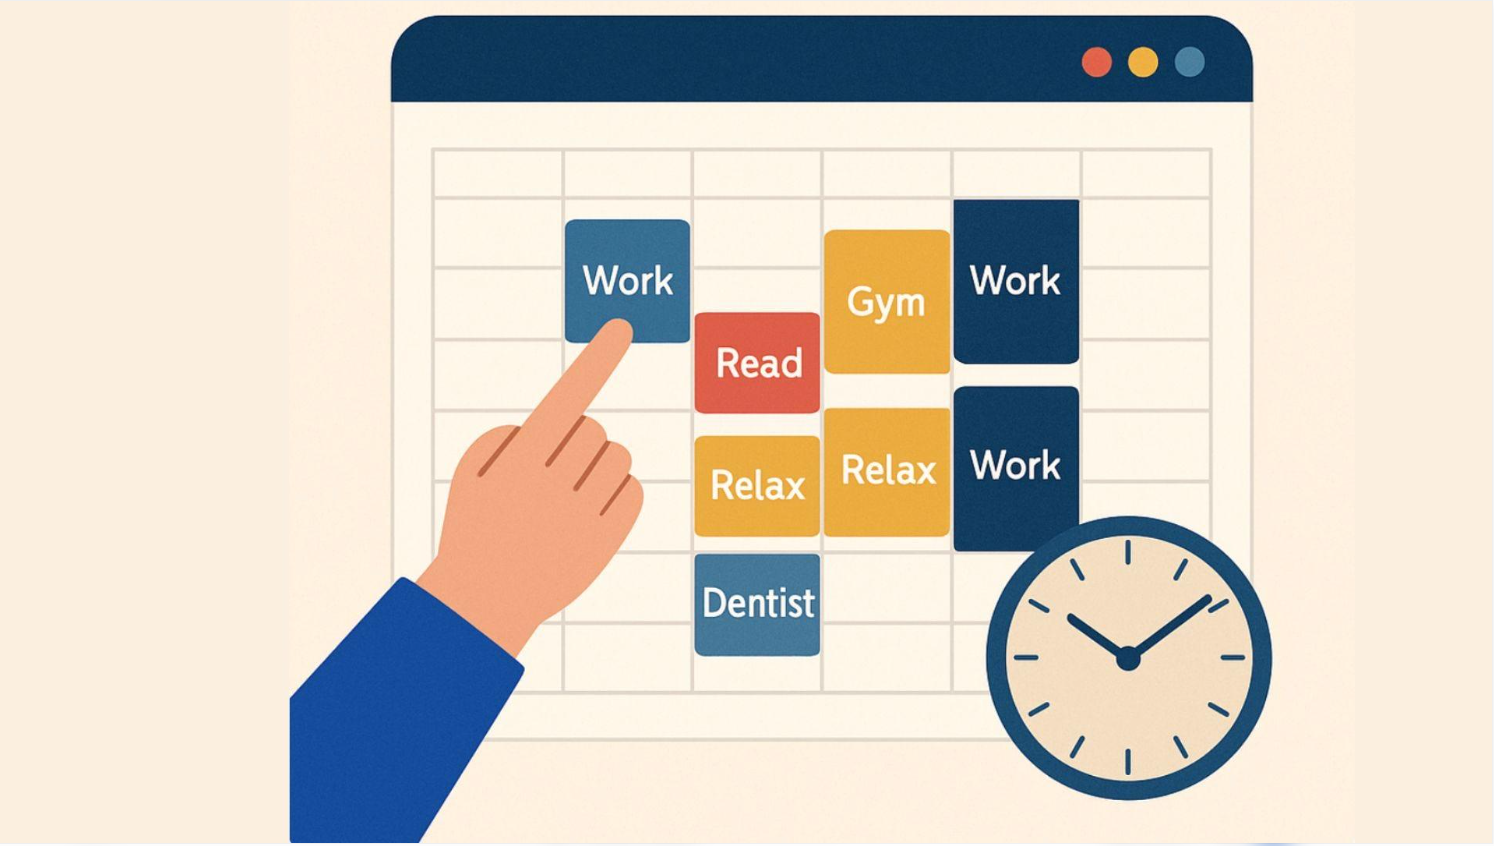
Wyobraźmy sobie, że jedna sala jest wykorzystywana do organizowania różnych spotkań. Każde spotkanie ma określoną godzinę rozpoczęcia i zakończenia.

Naszym zadaniem jest wybranie jak największej liczby spotkań, które nie będą odbywać się jednocześnie.

Dane spotkania:

Spotkanie

Początek

Koniec

A

9:00

10:00

B

9:30

11:00

C

10:00

11:00

D

11:00

12:00

E

10:30

12:30

F

12:00

13:00

Zasada działania algorytmu zachłannego:

Wybieramy spotkanie, które kończy się najwcześniej. Następnie wybieramy kolejne spotkanie, które rozpoczyna się po zakończeniu poprzedniego.

Analiza krok po kroku:

  1. Na początku wybieramy spotkanie A (9:00–10:00), ponieważ kończy się najwcześniej.

  2. Spotkanie B odpada, ponieważ rozpoczyna się o 9:30, czyli przed zakończeniem A.

  3. Spotkanie C możemy wybrać, ponieważ rozpoczyna się dokładnie o 10:00, gdy A się kończy.

  4. Spotkanie D również możemy wybrać, ponieważ rozpoczyna się o 11:00, czyli po zakończeniu C.

  5. Spotkanie E odpada, ponieważ zaczyna się o 10:30, gdy trwa jeszcze C.

  6. Spotkanie F możemy wybrać, ponieważ rozpoczyna się o 12:00, po zakończeniu D.

Harmonogram wybranych spotkań

A


09:00–10:00

C


10:00–11:00

D


11:00–12:00

F


12:00–13:00

Wybrano 4 spotkania

Dokładna analiza:

Ostatecznie otrzymujemy zestaw spotkań A, C, D i F.

Nie można wybrać większej liczby spotkań, ponieważ wszystkie muszą odbywać się bez nakładania się godzin.

Dlaczego metoda jest zachłanna? Ponieważ za każdym razem wybieramy spotkanie kończące się najwcześniej. Dzięki temu pozostawiamy jak najwięcej czasu na kolejne spotkania.

Złożoność obliczeniowa: \(O(n\log n)\), jeśli musimy najpierw posortować spotkania według czasu zakończenia. Sam wybór po sortowaniu zajmuje \(O(n)\).

Przykład 3. Algorytm Kruskala – minimalne drzewo rozpinające
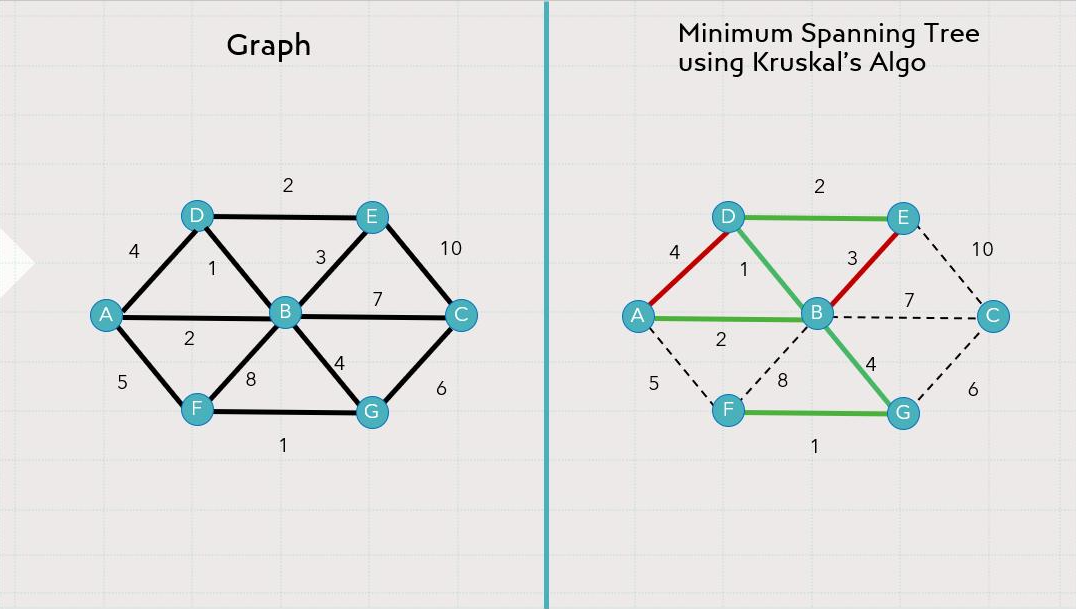
Opis problemu:

Wyobraźmy sobie, że chcemy połączyć pięć miast siecią kabli internetowych. Każde połączenie między miastami ma określony koszt.

Naszym zadaniem jest połączenie wszystkich miast w taki sposób, aby:

  • każde miasto było połączone z pozostałymi przez sieć,

  • całkowity koszt połączeń był jak najmniejszy,

  • nie powstawały niepotrzebne cykle.

Dane połączenia:

Połączenie

Koszt

A–B

1

B–C

2

A–C

3

B–D

4

C–D

5

C–E

6

D–E

7

Zasada działania algorytmu Kruskala:

Algorytm wybiera krawędzie (połączenia) od najtańszej do najdroższej, ale nie dopuszcza do utworzenia cyklu.

Analiza krok po kroku:

  1. Wybieramy A–B o koszcie 1. Miasta A i B zostają połączone.

  2. Wybieramy B–C o koszcie 2. Do sieci dołącza miasto C.

  3. Rozważamy A–C o koszcie 3, ale odrzucamy to połączenie, ponieważ A, B i C są już połączone. Powstałby cykl.

  4. Wybieramy B–D o koszcie 4. Do sieci dołącza miasto D.

  5. Rozważamy C–D o koszcie 5, ale odrzucamy, ponieważ powstałby cykl.

  6. Wybieramy C–E o koszcie 6. Do sieci dołącza ostatnie miasto E.

  7. Kończymy, ponieważ wszystkie miasta są połączone.

Wynik algorytmu Kruskala


Wybrane krawędzie

4

Łączny koszt

13

1 + 2 + 4 + 6 = 13

Dokładna analiza:

Algorytm Kruskala nie wybiera po prostu najtańszych połączeń. Musi również kontrolować, czy dodanie kolejnego połączenia nie spowoduje powstania cyklu.

Dla pięciu miast potrzebujemy dokładnie czterech połączeń, ponieważ minimalne drzewo rozpinające graf z \(n\) wierzchołkami zawiera \(n-1\) krawędzi.

Algorytm wykorzystuje lokalną decyzję: wybiera najtańszą krawędź, która nie powoduje cyklu.

Złożoność obliczeniowa: \(O(E\log E)\), gdzie \(E\) oznacza liczbę krawędzi grafu. Do sprawdzania cykli najczęściej wykorzystuje się strukturę Union-Find.

Przykład 4. Algorytm Dijkstry – najkrótsza droga
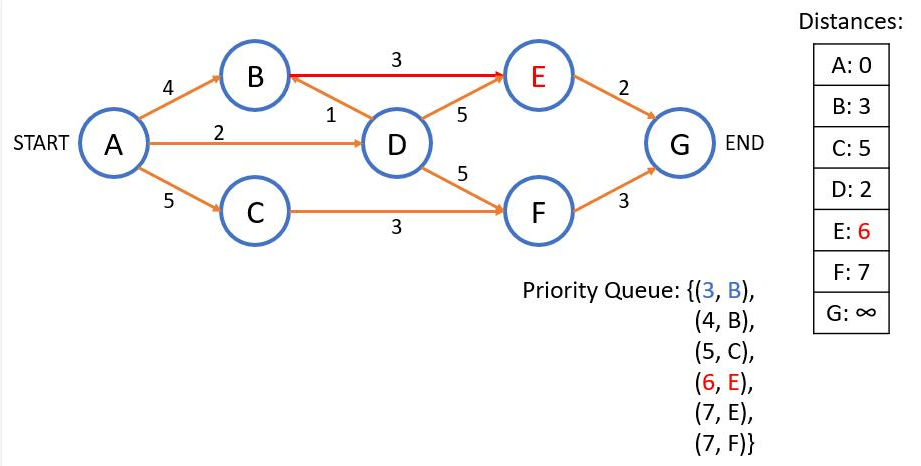
Opis problemu:

Wyobraźmy sobie, że chcemy znaleźć najkrótszą drogę z miasta A do miasta E. Miasta są połączone drogami, a każda droga ma określoną długość.

Naszym zadaniem jest znalezienie trasy, której łączna długość będzie najmniejsza.

Dane połączenia:

Droga

Długość

A–B

4 km

A–C

2 km

C–B

1 km

B–D

5 km

C–D

8 km

B–E

7 km

D–E

2 km

Zasada działania algorytmu Dijkstry:

Algorytm rozpoczyna działanie w wybranym wierzchołku i stopniowo ustala najkrótsze odległości do pozostałych wierzchołków.

W każdym kroku wybiera nieodwiedzony wierzchołek, do którego aktualnie znamy najmniejszą odległość.

Analiza krok po kroku:

Początkowo odległość od A do A wynosi 0, a do pozostałych miast jest nieskończona.

1. Zaczynamy w A. Ustalamy:

  • A–B = 4 km,

  • A–C = 2 km.

2. Wybieramy C, ponieważ aktualnie jest bliżej (2 km).

  • Przez C możemy dotrzeć do B za 2 + 1 = 3 km.

  • Poprawiamy więc wcześniejszą odległość do B z 4 km na 3 km.

  • Do D możemy dotrzeć za 2 + 8 = 10 km.

3. Wybieramy B, ponieważ odległość 3 km jest teraz najmniejsza.

  • Przez B do D możemy dotrzeć za 3 + 5 = 8 km.

  • Poprawiamy odległość do D z 10 km na 8 km.

  • Do E możemy dotrzeć za 3 + 7 = 10 km.

4. Wybieramy D, ponieważ jego aktualna odległość wynosi 8 km.

  • Przez D do E możemy dotrzeć za 8 + 2 = 10 km.

  • Odległość do E pozostaje bez zmian.

5. Wybieramy E. Algorytm kończy działanie.

Tabela aktualizowanych odległości:

Etap

A

B

C

D

E

Start

0

∞

∞

∞

∞

Po A

0

4

2

∞

∞

Po C

0

3

2

10

∞

Po B

0

3

2

8

10

Po D

0

3

2

8

10

Po E

0

3

2

8

10

Znaleziony najkrótszy szlak

A

C

B

D

E

10 km

2 + 1 + 5 + 2 = 10 km

Dokładna analiza:

Najważniejsze w tym algorytmie jest to, że nie wybieramy bezpośrednio najkrótszej drogi między A i E.

Zamiast tego analizujemy wszystkie dostępne połączenia i aktualizujemy odległości, jeśli znajdziemy krótszą trasę.

Algorytm jest zachłanny, ponieważ za każdym razem wybiera wierzchołek o najmniejszej aktualnie znanej odległości.

Ważna uwaga: Algorytm Dijkstry działa poprawnie dla grafów z nieujemnymi wagami krawędzi. Nie powinno się stosować go do grafów z ujemnymi wagami.

Złożoność obliczeniowa: Przy wykorzystaniu kolejki priorytetowej i list sąsiedztwa wynosi \(O((V+E)\log V)\).


.

4. Porównanie czterech algorytmów

Algorytm

Do czego służy?

Lokalna decyzja

Wydawanie reszty

Minimalna liczba monet

Wybór największego nominału

Wybór aktywności

Maksymalna liczba spotkań

Wybór najwcześniej kończącego się spotkania

Kruskal

Minimalny koszt połączenia sieci

Wybór najtańszej krawędzi bez cyklu

Dijkstra

Najkrótsza droga

Wybór najbliższego nieodwiedzonego wierzchołka

5. Zalety i wady algorytmów zachłannych

Zalety:

  • Są zazwyczaj proste do napisania i zrozumienia.

  • Często charakteryzują się niewielką złożonością obliczeniową.

  • Nie wymagają analizowania wszystkich możliwych kombinacji.

  • Dobrze sprawdzają się w wielu problemach optymalizacyjnych.

Wady:

  • Nie zawsze znajdują rozwiązanie optymalne.

  • Nie analizują wszystkich możliwych konsekwencji podejmowanych decyzji.

  • Wybór najlepszej lokalnie opcji może doprowadzić do gorszego wyniku końcowego.

  • Wymagają odpowiedniego dobrania strategii zachłannej do konkretnego problemu.

6. Podsumowanie

Algorytmy zachłanne lokalne są metodą rozwiązywania problemów polegającą na podejmowaniu najlepszych możliwych decyzji w danym momencie. Ich największą zaletą jest prostota i szybkość działania. Nie zawsze jednak gwarantują znalezienie najlepszego rozwiązania globalnego.

Przedstawione przykłady pokazują różne zastosowania tej metody:

  • Wydawanie reszty pokazuje, jak wybierać największe dostępne nominały.

  • Problem wyboru aktywności pokazuje, jak maksymalizować liczbę wykonanych zadań.

  • Algorytm Kruskala pokazuje, jak minimalizować koszt budowy sieci.

  • Algorytm Dijkstry pokazuje, jak znajdować najkrótsze drogi w grafie.

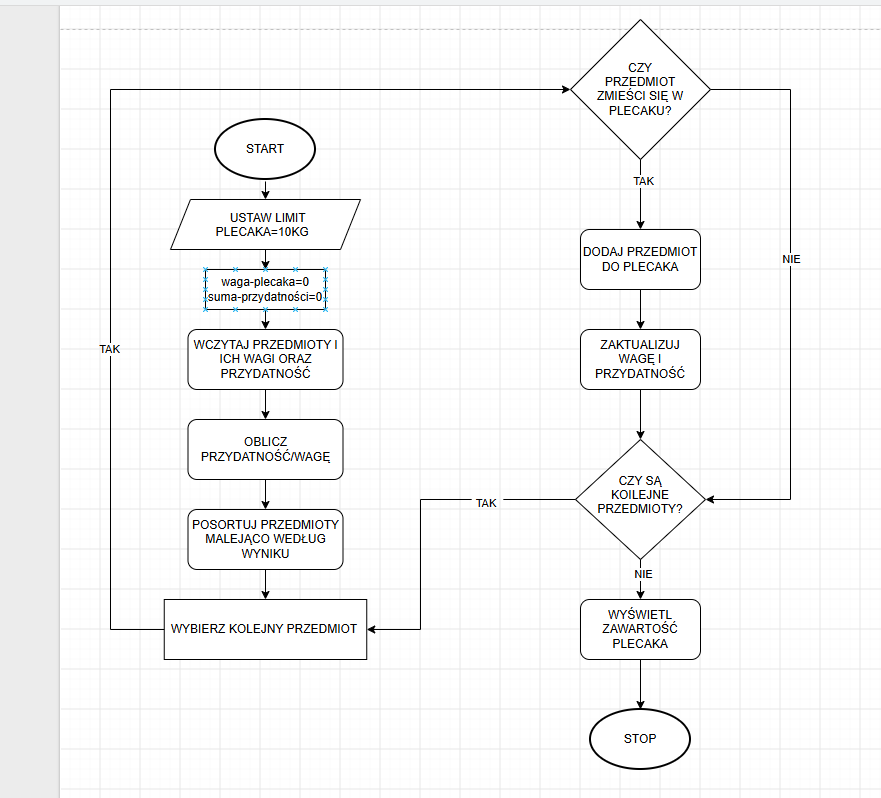
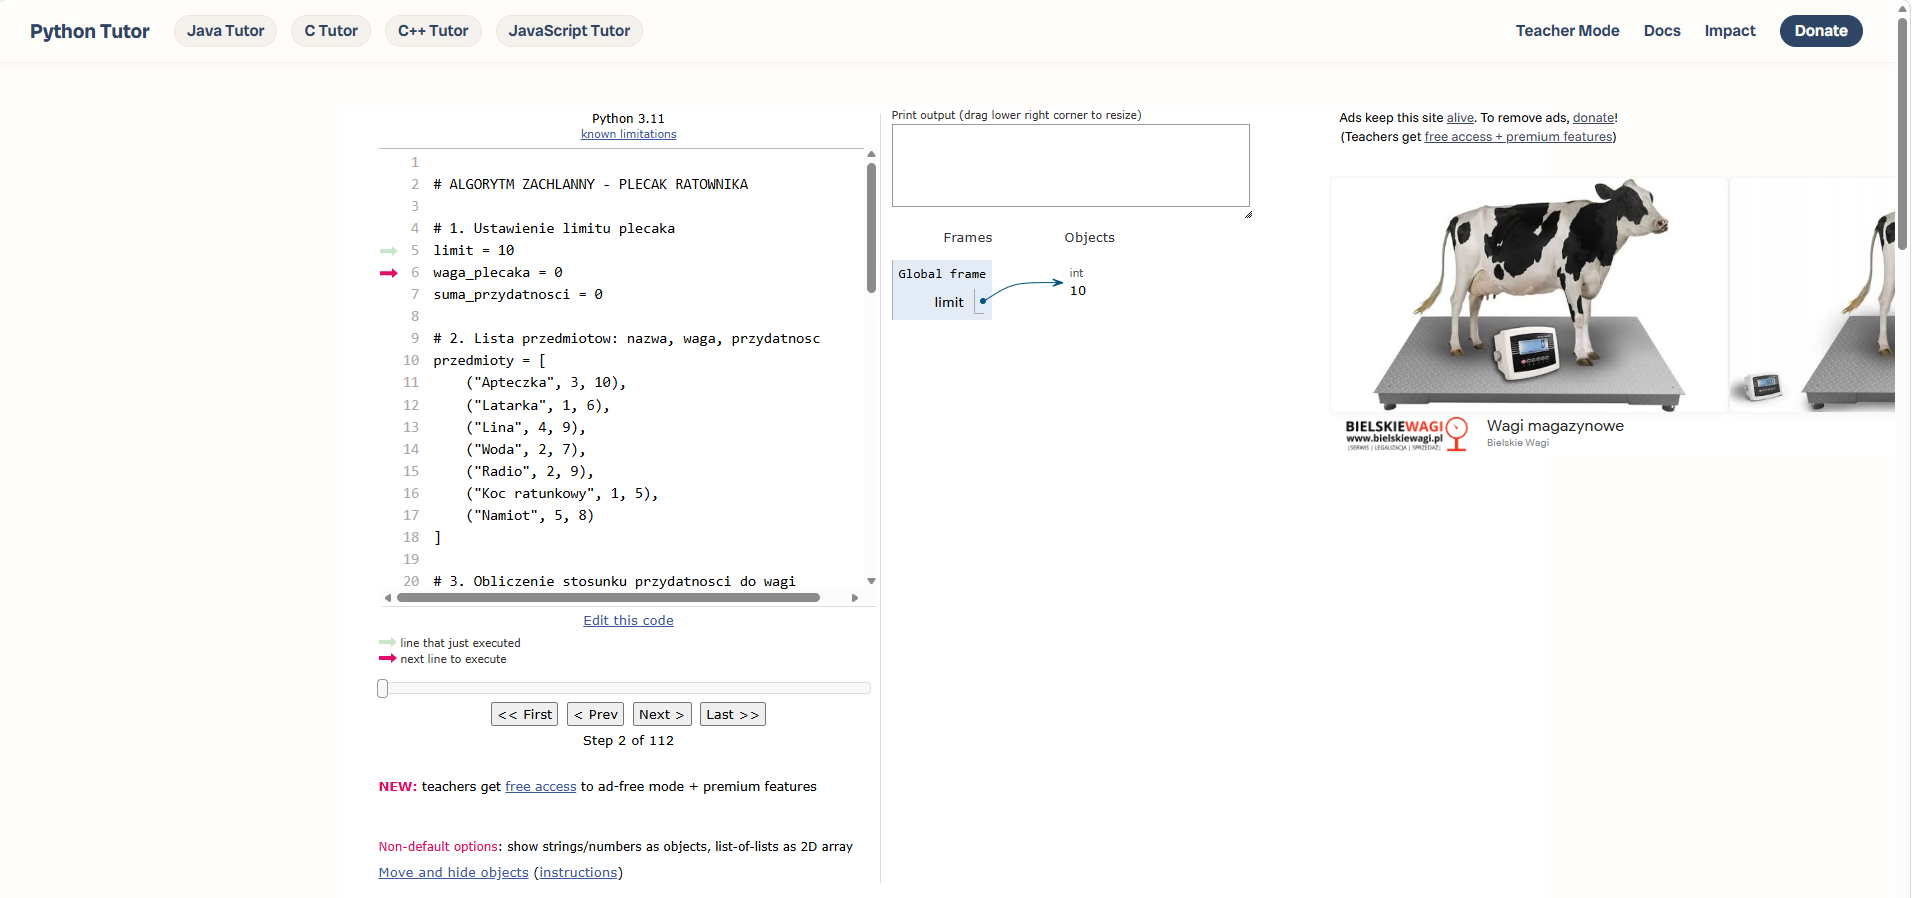
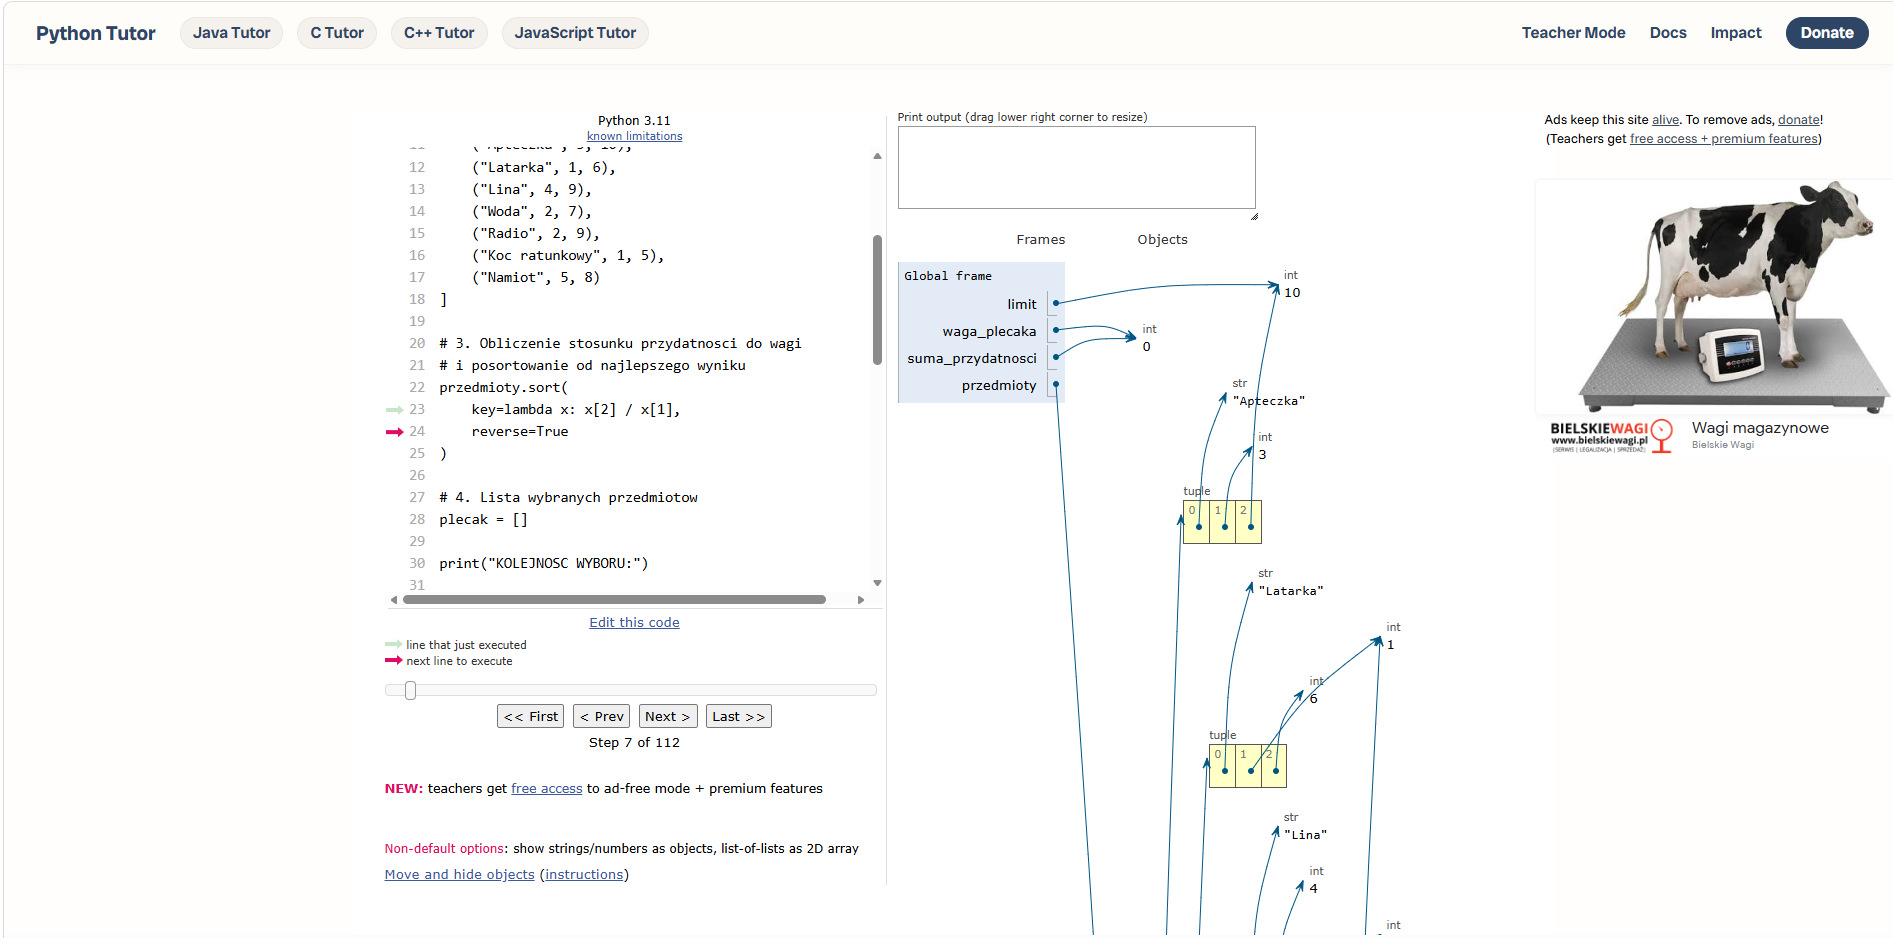
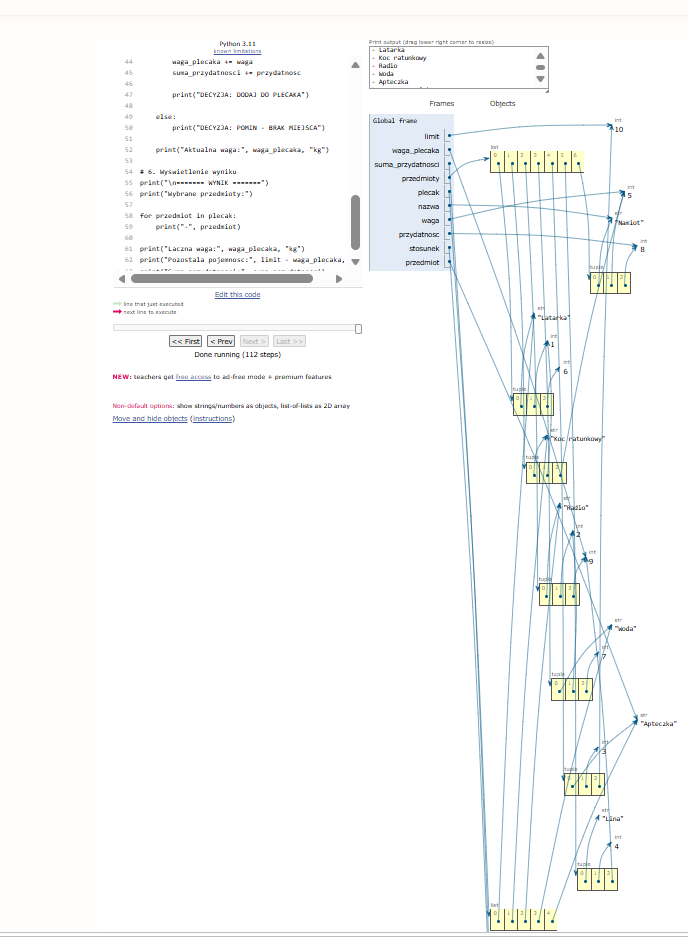
Gotowy kod – plecak ratownika górskiego

Poprawiłem wcześniejszy przykład i przygotowałem kompletny kod. Uwzględniłem:

  • limit plecaka 10 kg,

  • obliczanie przydatności względem wagi,

  • sortowanie malejące,

  • wybieranie przedmiotów,

  • pomijanie tych, które się nie mieszczą,

  • wyświetlanie końcowego wyniku.


# ALGORYTM ZACHLANNY – PLECAK RATOWNIKA

# 1. Ustawienie limitu plecaka
limit = 10
waga_plecaka = 0
suma_przydatnosci = 0

# 2. Lista przedmiotow: nazwa, waga, przydatnosc
przedmioty = [
(„Apteczka”, 3, 10),
(„Latarka”, 1, 6),
(„Lina”, 4, 9),
(„Woda”, 2, 7),
(„Radio”, 2, 9),
(„Koc ratunkowy”, 1, 5),
(„Namiot”, 5, 8)
]

# 3. Obliczenie stosunku przydatnosci do wagi
# i posortowanie od najlepszego wyniku
przedmioty.sort(
key=lambda x: x[2] / x[1],
reverse=True
)

# 4. Lista wybranych przedmiotow
plecak = []

print(„KOLEJNOSC WYBORU:”)

# 5. Algorytm zachlanny
for nazwa, waga, przydatnosc in przedmioty:

stosunek = przydatnosc / waga

print(„\nSprawdzam:”, nazwa)
print(„Stosunek:”, round(stosunek, 2))

# Sprawdzenie, czy przedmiot sie zmiesci
if waga_plecaka + waga <= limit:

plecak.append(nazwa)
waga_plecaka += waga
suma_przydatnosci += przydatnosc

print(„DECYZJA: DODAJ DO PLECAKA”)

else:
print(„DECYZJA: POMIN – BRAK MIEJSCA”)

print(„Aktualna waga:”, waga_plecaka, „kg”)

# 6. Wyswietlenie wyniku
print(„\n======= WYNIK =======”)
print(„Wybrane przedmioty:”)

for przedmiot in plecak:
print(„-„, przedmiot)

print(„Laczna waga:”, waga_plecaka, „kg”)
print(„Pozostala pojemnosc:”, limit – waga_plecaka, „kg”)
print(„Suma przydatnosci:”, suma_przydatnosci)